 Shopify
 WooCommerce
 API
Modelo de difusión
Arquitectura de IA generativa que crea imágenes aprendiendo a revertir un proceso de adición gradual de ruido.
¿Qué es un modelo de difusión?
Un modelo de difusión es una arquitectura de IA generativa que crea imágenes aprendiendo a revertir un proceso de adición de ruido. Durante la fase de entrenamiento, las imágenes se alteran progresivamente hasta destruirse con ruido aleatorio y el modelo aprende a deshacer cada paso. Al generar una imagen, parte de ruido puro y lo va eliminando gradualmente hasta formar una imagen nueva, guiándose por instrucciones de texto (prompts), una imagen de referencia o ambas.
Los modelos de difusión son la base de la mayoría de los generadores de imágenes más avanzados, incluidos los sistemas de transferencia de prendas que se usan en los probadores virtuales basados en imágenes.
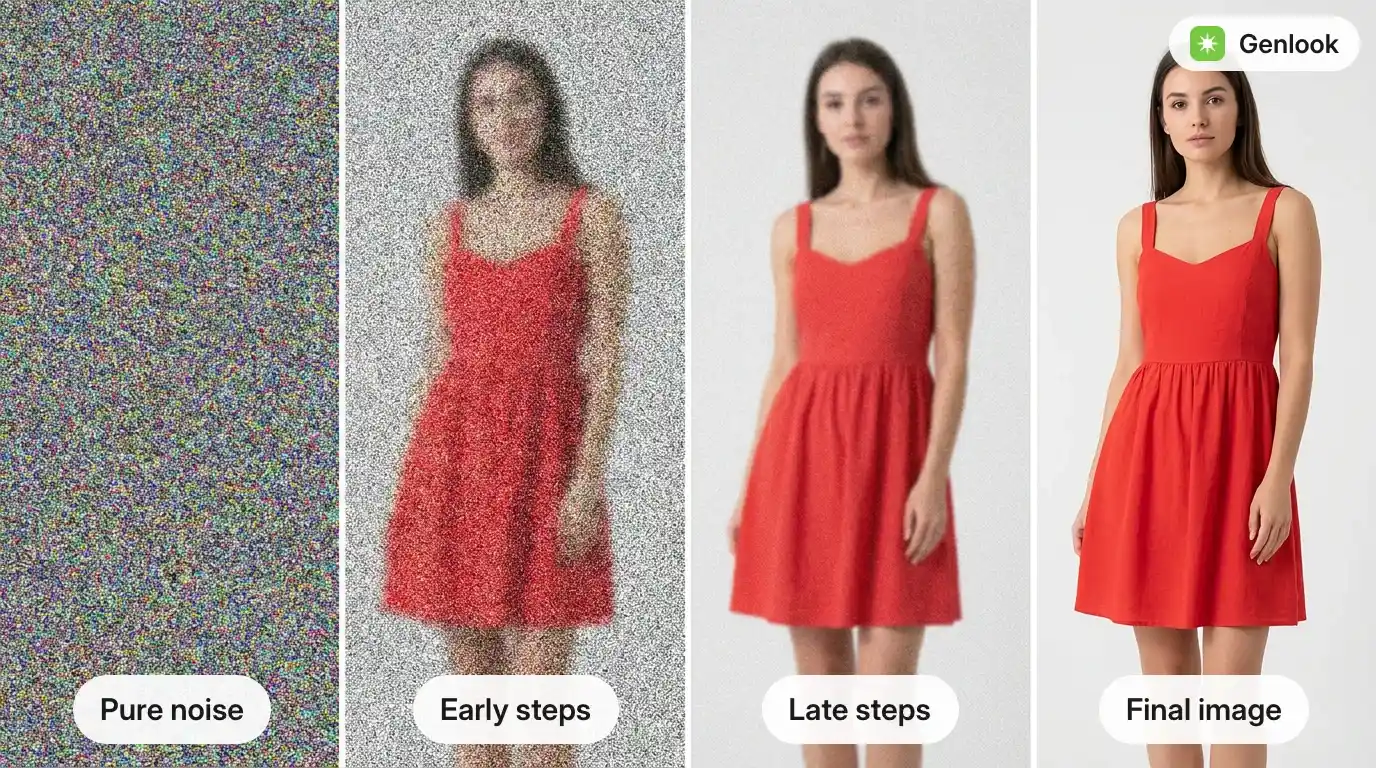
Cómo funciona
- Proceso directo (entrenamiento): se añade ruido a una imagen real en muchos pasos pequeños hasta que solo queda estática.
- Proceso inverso aprendido: se entrena al modelo para que prediga el estado anterior, con menos ruido, en cada paso.
- Generación: empezando con ruido aleatorio, se aplica repetidamente la eliminación de ruido aprendida (normalmente de 20 a 50 pasos) hasta que surge una imagen coherente.
- Condicionamiento: en cada paso, el modelo puede ser guiado por entradas como la imagen de una prenda, la postura del cuerpo o una máscara de la región a repintar.
Su papel en los probadores virtuales
El condicionamiento es lo que convierte a un generador de imágenes general en un motor de probador virtual: a partir de la foto de una persona, la foto de una prenda y una máscara de la ropa, el modelo regenera solo la región enmascarada (ver repintado de imágenes) con la textura de la tela, las arrugas y la iluminación acordes a la foto original.
La contrapartida es la velocidad: la generación tarda varios segundos y requiere cálculo por GPU, razón por la cual los probadores virtuales basados en difusión producen imágenes estáticas en lugar de superposiciones de vídeo en tiempo real.
FAQ
Preguntas, respondidas.
¿Por qué los modelos de difusión sustituyeron a las redes GAN en los probadores virtuales?↓
Las primeras investigaciones sobre probadores virtuales utilizaban redes GAN, pero los modelos de difusión demostraron ser más estables a la hora de entrenarlos, más fáciles de controlar mediante el condicionamiento y más eficaces a la hora de reproducir texturas finas. Todo esto es fundamental cuando hablamos de ropa.