
 Shopify
 WooCommerce
A 20 de setembro de 2026, a equipa do Qwen no Alibaba disponibilizou o Qwen-Image-2.1 em código aberto. Trata-se de um modelo de imagem de 7B que gera e edita num único fluxo de trabalho, suporta até 10 imagens de referência e aponta o provador virtual como um dos principais casos de uso.
Testámo-lo nos oito pares de pessoa-peça que usamos para avaliar qualquer motor, lado a lado com o modelo de provador virtual da Google no Vertex AI, uma das opções comerciais mais comuns no mercado. Usámos as mesmas fotografias, a mesma cadeia de prompts e sem qualquer ajuste fino (fine-tuning).
O que é o Qwen-Image-2.1?
O Qwen-Image-2.1 substitui três modelos anteriores (Qwen-Image para geração, Qwen-Image-Edit para edição e Qwen-Image-Layered para transparência) num único checkpoint.
- 7B de parâmetros na componente de geração (32 camadas DiT de fluxo único). O Qwen3-VL 8B lê o prompt e as imagens de entrada.
- Até 10 imagens de referência numa só edição. Citando a página de lançamento: "para um provador virtual, cinco entradas (um modelo, roupa, sapatos, uma mala e um chapéu) podem ser combinadas para criar um visual completo."
- Edição de regiões. Desenhe um círculo à volta de uma área, pinte sobre ela ou introduza uma máscara à parte, e apenas essa região sofrerá alterações.
- Fidelidade de pessoas e produtos é um objetivo declarado no treino: os rostos mantêm-se inalterados nas edições, e "texto, texturas e formato" dos produtos são preservados.
- Transparência nativa. Saída RGBA a partir de um prompt e extração do motivo central de uma fotografia como uma camada transparente.
- Inferência eficiente. As imagens de entrada e a instrução são codificadas apenas uma vez e guardadas em cache para cada etapa de eliminação de ruído, pelo que uma edição com dez referências custa praticamente o mesmo por passo que uma edição com uma única referência.
No Qwen-Image-Bench da própria equipa, o modelo obteve uma pontuação de 60,28, classificando-se em sétimo lugar entre 29 modelos. Os seis à frente são de código fechado (o GPT Image 2.5 lidera com 67,01). Entre os modelos de pesos abertos, lidera com larga margem.
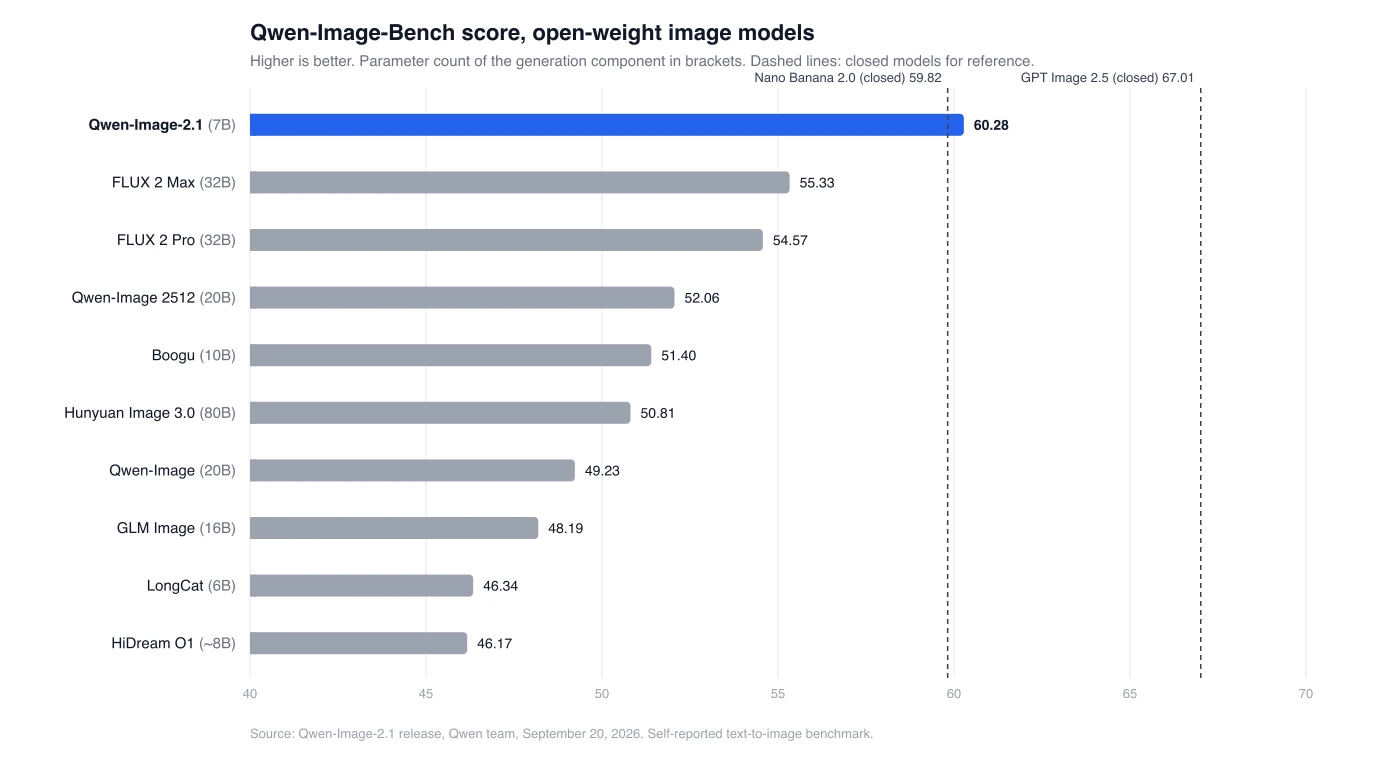
Trata-se de um benchmark auto-reportado que mede a geração e não a edição. Os pesos encontram-se disponíveis no Hugging Face e no ModelScope, com suporte no dia zero em Diffusers, ComfyUI, vLLM-Omni e SGLang.
A licença é a Qwen Research License, "apenas para fins não comerciais". O uso comercial exige um acordo em separado com o Alibaba. Mais pormenores abaixo.
Funciona para o provador virtual?
Sim, de forma nativa (zero-shot).
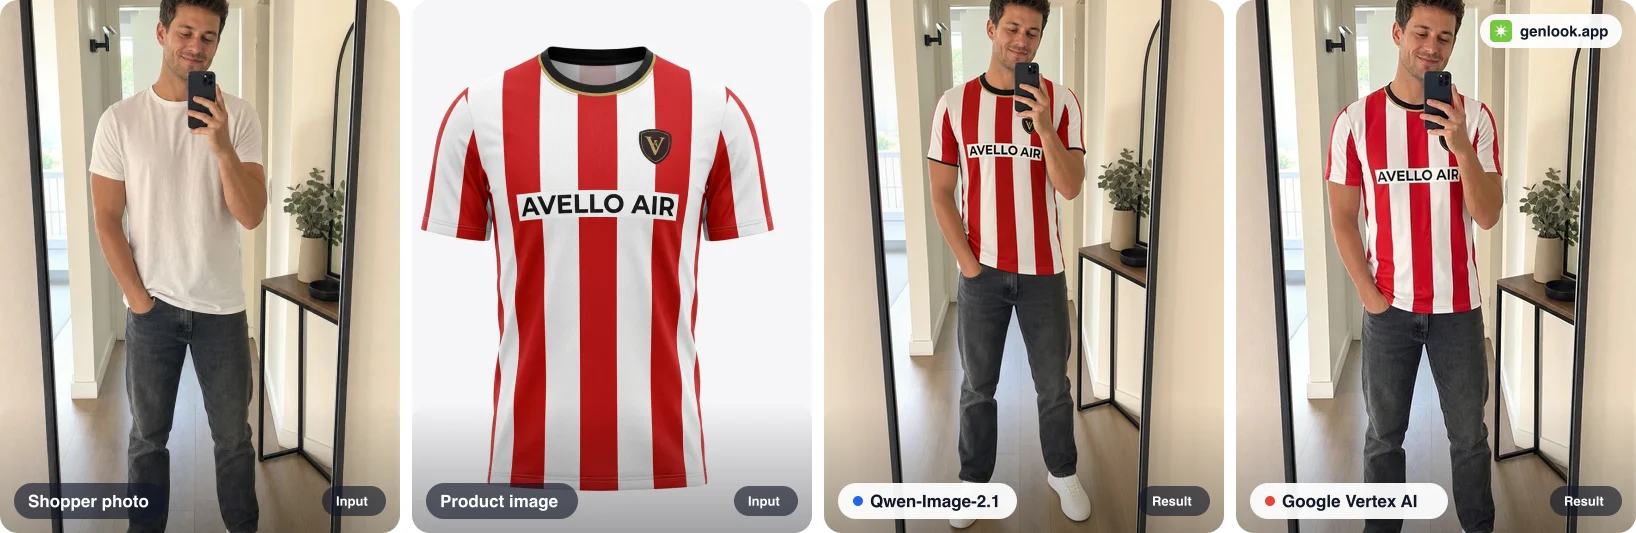
Configuração: oito pares dos nossos exemplos públicos de provadores virtuais, cada um composto por uma selfie ao espelho e a imagem do produto tal como o comerciante a carregaria (uma fotografia do produto plano ou vestido num modelo). O Qwen-Image-2.1 correu na Comfy Cloud com 16 passos. O Vertex AI foi executado através da sua API. Ambos passaram pela mesma cadeia de prompts, sem LoRA e sem qualquer pós-processamento. Cada painel lê-se da esquerda para a direita: fotografia do comprador, imagem do produto, Qwen-Image-2.1 e Google Vertex AI.
A camisola de futebol no topo da publicação é o teste de texto. Ambos os modelos mantêm o logótipo do patrocinador e o emblema legíveis e no sítio certo, e nenhum altera as mãos do comprador, o telemóvel ou o fundo.
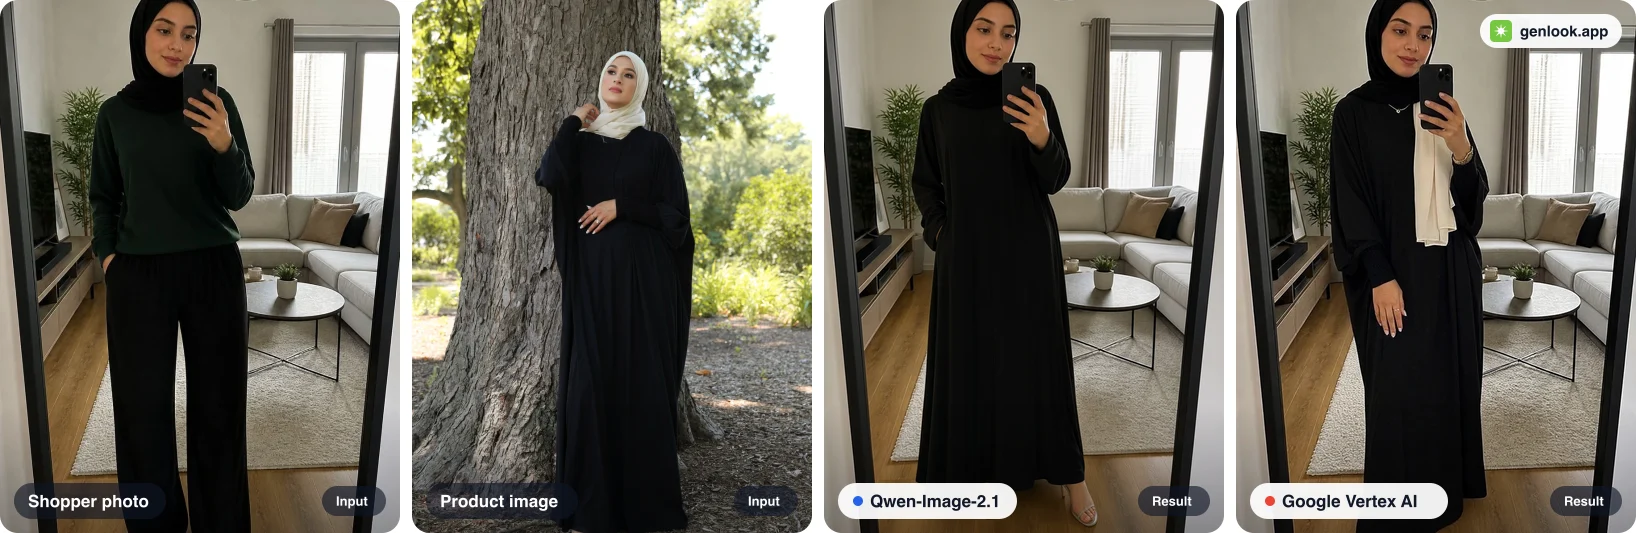
Onde o Qwen se sai melhor. A abaya foi fotografada numa modelo a usar um lenço creme. O Vertex AI transportou o lenço em conjunto com a peça de roupa. O Qwen mudou a abaya e mais nada.
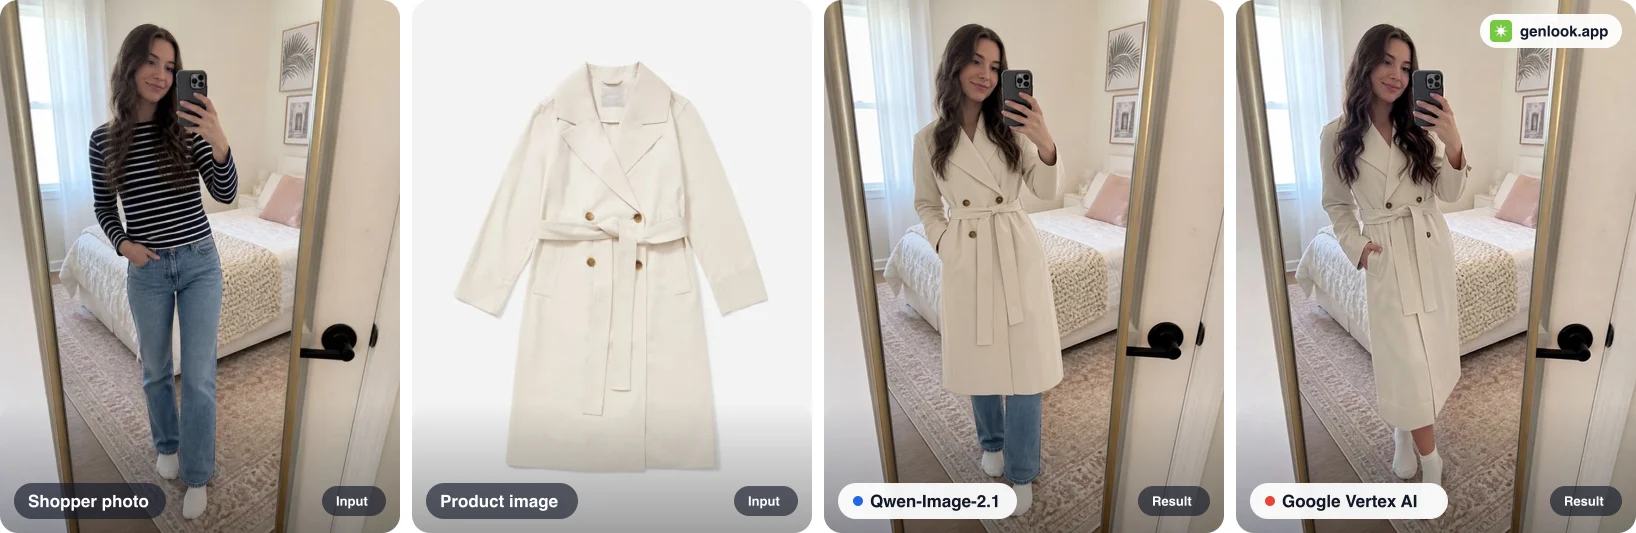
Onde o Qwen se sai pior. A fotografia plana mostra o casaco a meio da perna. O Vertex mantém o comprimento, enquanto o Qwen para pelo joelho. O cinto, o fecho e as lapelas estão corretos em ambos. O comprimento da bainha em peças compridas foi a falha consistente, algo que se voltou a notar num vestido comprido com folhos.
Nos outros cinco pares (um vestido pelo meio da perna com padrão floral, uma camisola de capuz néon, um saree de duas peças, um vestido comprido plus-size e um vestido de noiva de renda), não conseguimos distinguir um vencedor. Ambos transportaram bem a blusa e o rebordo do saree, acertaram na escala do padrão do vestido e não alteraram nenhum rosto.
Qwen-Image-2.1 vs Google Vertex AI provador virtual
| Qwen-Image-2.1 na Comfy Cloud | Provador virtual do Google Vertex AI | |
|---|---|---|
| Pares concluídos | 8 de 8 | 8 de 8 |
| Tempo mediano por provador virtual | 9,9 s | 9,3 s |
| Custo por provador virtual | aprox. 0,005 $ (tempo de GPU) | 0,06 $ (preço de tabela) |
| Qualidade, lado a lado | 6 empates, 1 melhor, 1 pior | 6 empates, 1 melhor, 1 pior |
| Pesos | abertos, podem sofrer fine-tuning | API fechada |
| Licença | apenas para investigação, comercial por acordo | comercial |
O tempo do Qwen inclui cerca de três segundos em fila de espera na Comfy Cloud. O custo do Qwen reflete apenas o tempo de GPU para o modelo; um pedido completo de provador virtual também corre a classificação da peça de roupa, a construção do prompt e verificações de qualidade.
O senão
Licença. O Qwen-Image-2.1 foi lançado sob o Qwen Research License Agreement, e não com a licença Apache 2.0 como o Qwen-Image-Edit-2511. O ficheiro de licença permite a sua utilização "apenas para fins não comerciais", definidos como investigação ou avaliação, direcionando os utilizadores comerciais para o pedido de licença ao Alibaba. Um botão de provador virtual numa loja online enquadra-se no uso comercial. Alojamento próprio (self-hosting) exige esse acordo.
As duas falhas. O comprimento das bainhas em peças compridas e a perda de peças secundárias em produtos compostos. Ambas são sistemáticas, que é precisamente para o que serve um LoRA. Com 7B, um adaptador treina-se numa única GPU numa questão de horas. O DiffSynth-Studio no ModelScope suporta treino com LoRA na versão 2.1 desde o primeiro dia, e a ComfyUI carrega adaptadores através dos seus nós habituais. Os dados de treino consistem numa fotografia no modelo associada à fotografia da peça plana, algo que os catálogos de moda já possuem. Um prompt que indique a categoria da peça de roupa, o fecho e o comprimento resolve grande parte das falhas na bainha, o LoRA trata do resto.
O que isto significa para a Genlook
O Qwen-Image-2.1 é o primeiro modelo aberto a conseguir paridade com uma API comercial de provador virtual nos nossos pares de teste, e por uma fração do custo por imagem. Estamos a atualizar a cadeia de fluxo de provador virtual da Genlook para utilizá-lo nas áreas em que é mais forte, juntando-lhe a classificação das peças, a construção de prompts e as verificações de qualidade que usamos em qualquer modelo. Desta forma, garantimos que todos os tipos de produto contam com a melhor qualidade de provador virtual disponível. As duas falhas mencionadas são os primeiros aspetos que o trabalho da cadeia de fluxo vai solucionar.
Para os programadores, a API Genlook Try-On oferece um ponto de acesso para todos os tipos de produto. Um crédito equivale a uma prova virtual: 0,04 $ no modelo "pay as you go" (pague consoante a utilização), ou desde 0,015 $ num plano mensal. Os créditos de pacotes nunca expiram, e as contas novas começam com créditos grátis. O guia de iniciação resume-se a quatro chamadas: criar um produto, carregar uma fotografia, gerar e obter o resultado.
Resumo
- O lançamento: um modelo de pesos abertos de 7B que gera, edita com até 10 referências e trata da transparência num só checkpoint. É o melhor modelo aberto no benchmark da equipa.
- No provador virtual: empata com o modelo Vertex AI da Google em 6 dos 8 pares, numa base zero-shot. É melhor a não tocar nos artigos que não sejam roupa e tem dificuldades com o comprimento das bainhas em peças compridas.
- Custo: cerca de 0,005 $ de tempo de GPU por imagem, em comparação com os 0,06 $.
- O senão: uma licença exclusiva para fins de investigação aplicável a alojares por ti mesmo, e duas falhas que se devem conseguir resolver com um LoRA.
Obtém uma chave API em platform.genlook.app para utilizar a API Genlook Try-On, ou adiciona o provador virtual à tua loja.
FAQ