 Shopify
 WooCommerce
 API
Modelo de Difusão
Uma arquitetura de IA generativa que cria imagens aprendendo a reverter um processo gradual de adição de ruído.
O que é um modelo de difusão?
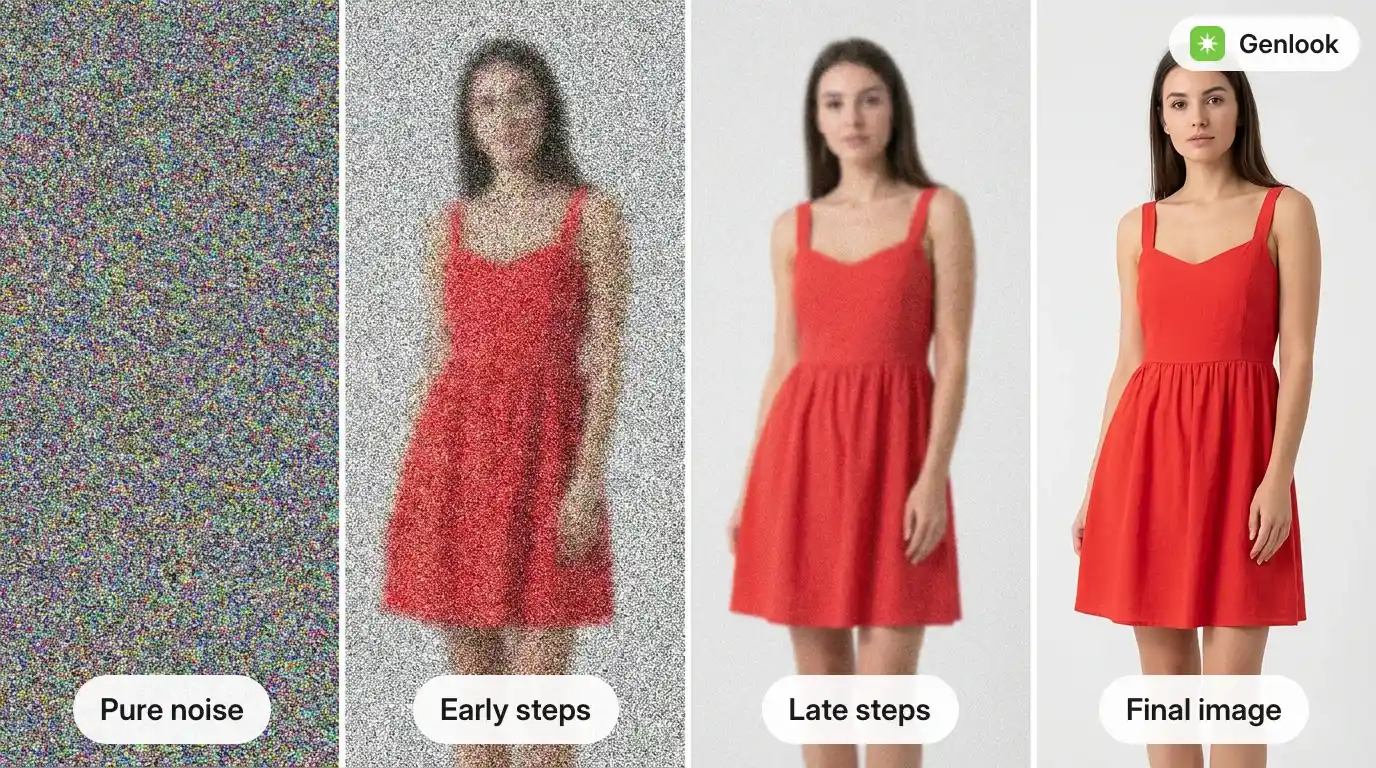
Um modelo de difusão é uma arquitetura de IA generativa que cria imagens aprendendo a reverter um processo de adição de ruído. Durante o treinamento, as imagens são progressivamente destruídas com ruído aleatório e o modelo aprende a desfazer cada etapa. No momento da geração, ele parte do ruído puro e o remove passo a passo, transformando-o numa nova imagem, guiado por um prompt de texto, uma imagem de referência ou ambos.
Os modelos de difusão são a base da maioria dos geradores de imagem de ponta, incluindo os sistemas de transferência de peças de roupa utilizados nos provadores virtuais baseados em imagens.
Como funciona
- Processo direto (treinamento): o ruído é adicionado a uma imagem real em pequenas etapas até que reste apenas estática.
- Processo reverso aprendido: o modelo é treinado para prever o estado anterior, com menos ruído, a cada etapa.
- Geração: começando com ruído aleatório, a remoção de ruído aprendida é aplicada repetidamente (geralmente entre 20 e 50 etapas) até surgir uma imagem coerente.
- Condicionamento: a cada etapa, o modelo pode ser direcionado por inputs como a imagem de uma peça de roupa, uma pose do corpo ou uma máscara da região a ser repintada.
O papel no provador virtual
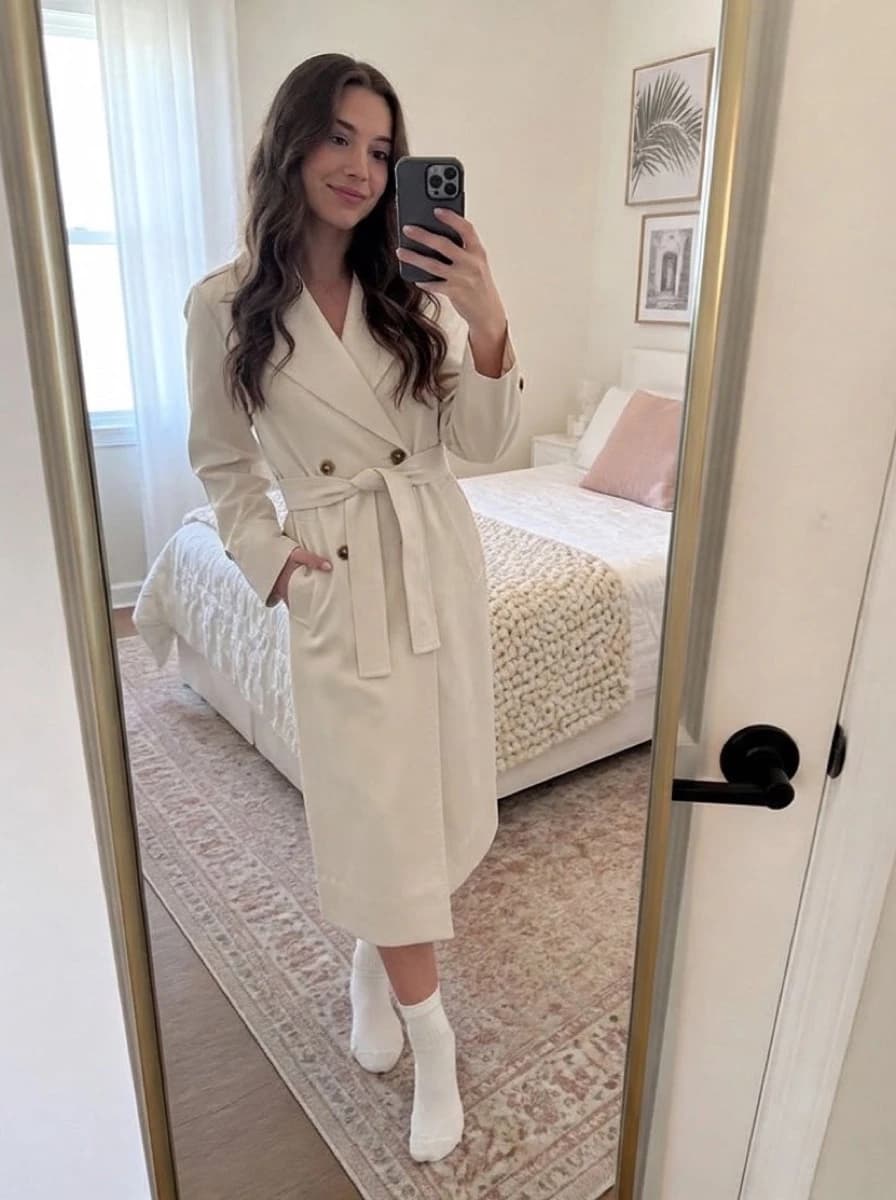
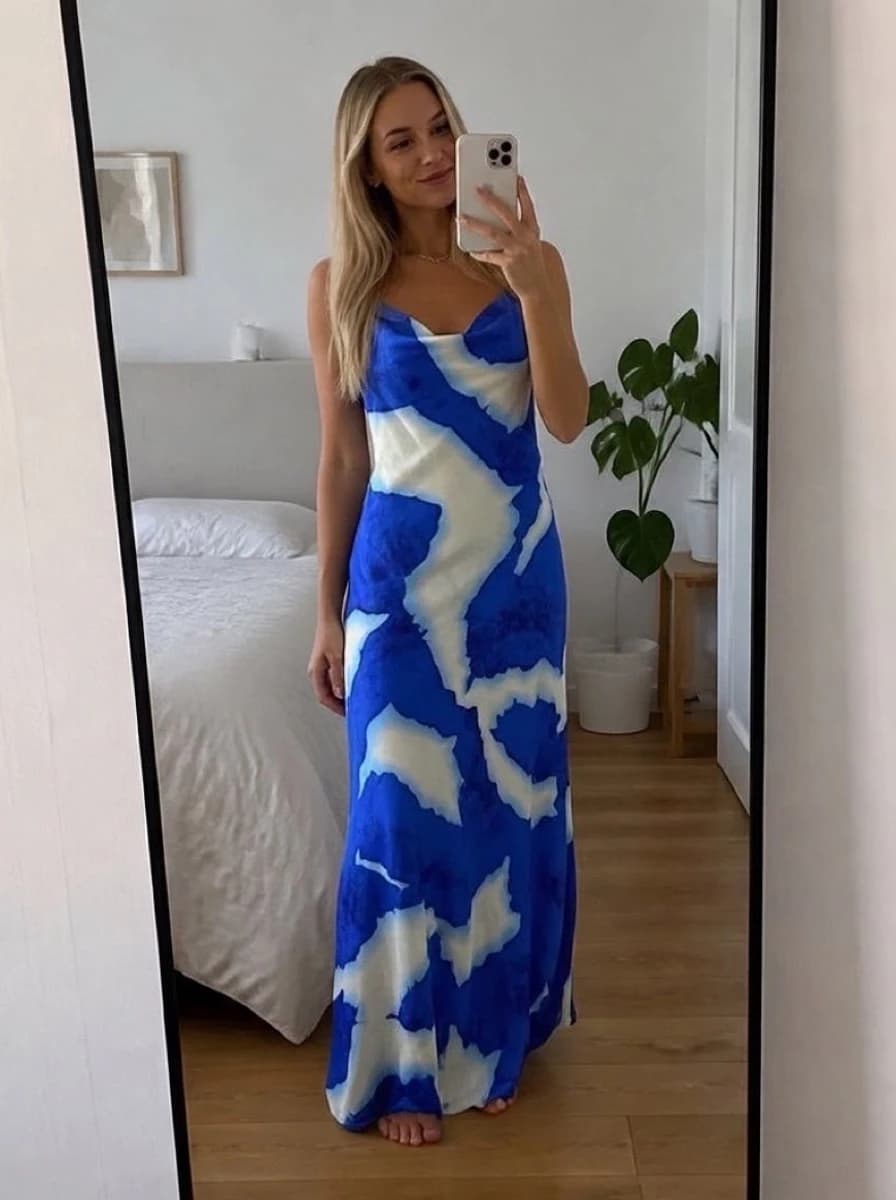
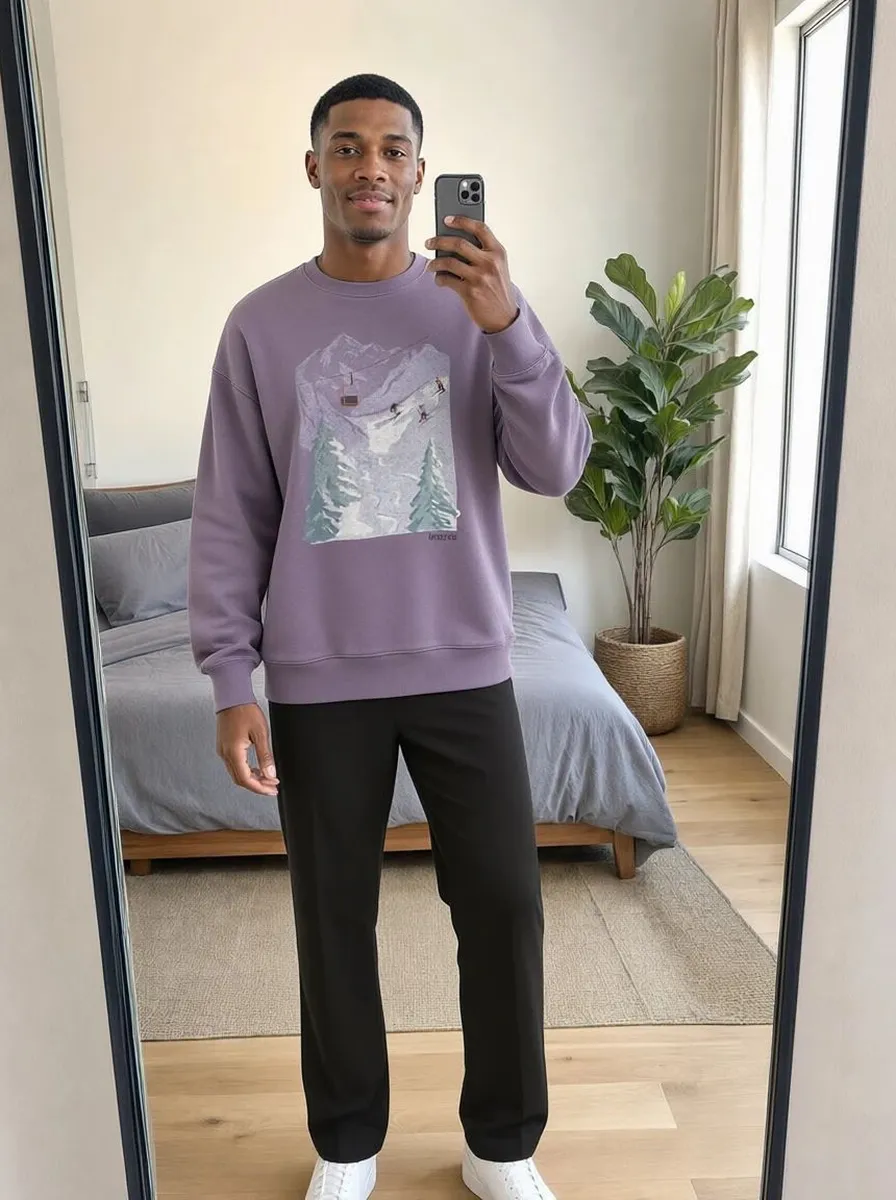
O condicionamento é o que transforma um gerador de imagens genérico em um motor de provador virtual: ao receber a foto de uma pessoa, a foto de uma peça e uma máscara de roupa, o modelo regenera apenas a região da máscara (veja image inpainting), mantendo a textura do tecido, as dobras e a iluminação consistentes com a foto original.
A contrapartida é a velocidade: a geração leva segundos e exige processamento de GPU. É por isso que os provadores baseados em difusão geram imagens estáticas em vez de sobreposições de vídeo em tempo real.
FAQ
Dúvidas respondidas.
Por que os modelos de difusão substituíram as GANs nos provadores virtuais?↓
As primeiras pesquisas sobre provadores virtuais usavam GANs, mas os modelos de difusão provaram ser mais estáveis de treinar, mais controláveis através de condicionamento e muito melhores na reprodução de texturas finas. Tudo isso é fundamental quando se trata de roupas.