 Shopify
 WooCommerce
 API
拡散モデル
画像にノイズを加えるプロセスを逆行させる学習を通じて、新しい画像を生成するAIアーキテクチャ。
拡散モデルとは?
拡散モデルは、画像にノイズを加えるプロセスを逆行(ノイズ除去)させる学習を通じて画像を生成するAIアーキテクチャです。学習時には、ランダムなノイズを段階的に加えて画像を完全に破壊し、モデルはその各ステップを元に戻す方法を学習します。生成時には、純粋なノイズの状態からスタートし、テキストプロンプトや参照画像などの指示に従いながら段階的にノイズを除去して新しい画像を作り出します。
拡散モデルは、画像ベースのバーチャル試着に使用される衣服の転送システムをはじめとする、大半の最先端の画像生成AIの基盤となっています。
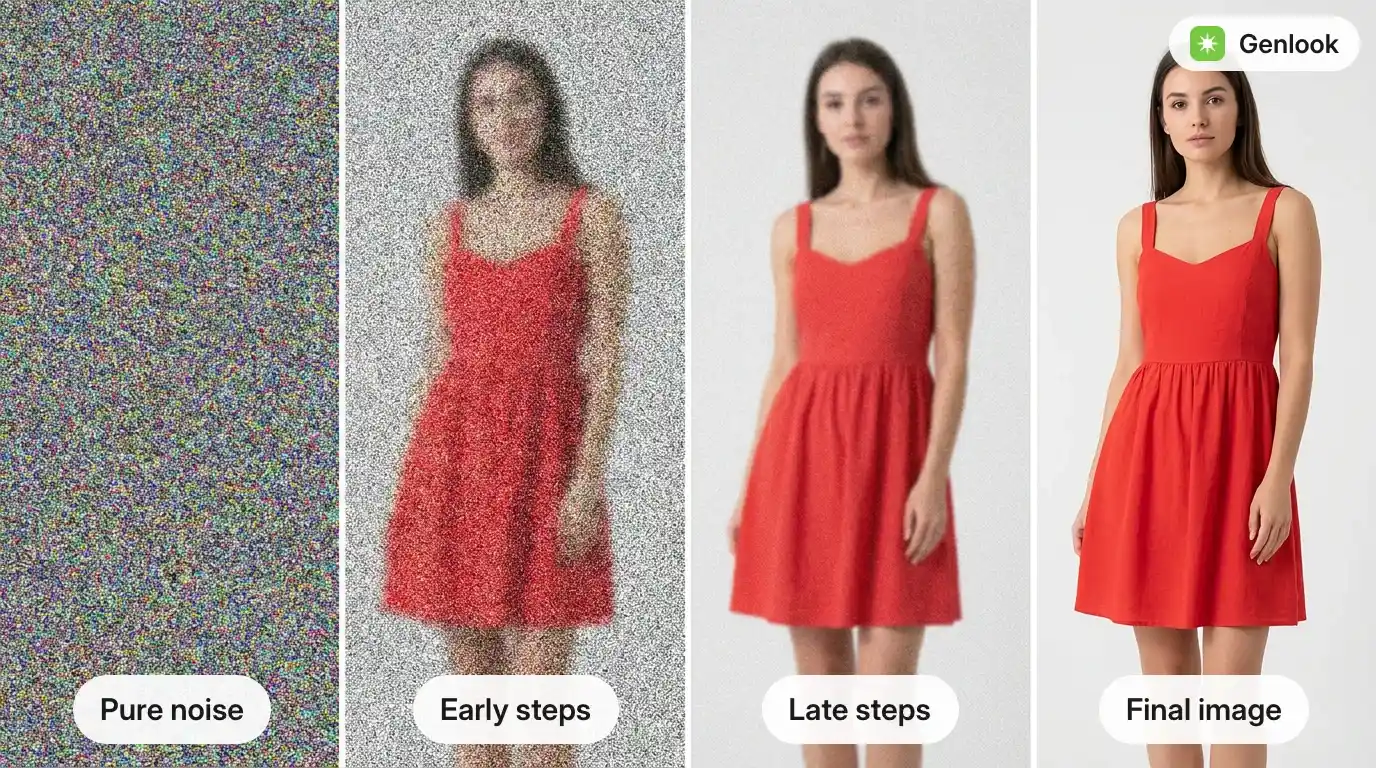
仕組み
- 順方向プロセス(学習): 実際の画像に対し、元の情報が完全に失われるまで少しずつ細かいノイズを加えます。
- 逆方向プロセス(学習): モデルは各ステップで、ノイズを加える前の状態(ノイズが少ない状態)を予測・復元するよう訓練されます。
- 生成: ランダムなノイズから開始し、学習したノイズ除去プロセスを繰り返し適用(通常20〜50ステップ)することで、一貫性のある画像を浮かび上がらせます。
- 条件付け(Conditioning): 各ステップにおいて、衣服の画像、身体のポーズ、再描画する領域のマスクといった入力を与えることで、生成方向を制御できます。
バーチャル試着における役割
この「条件付け」こそが、一般的な画像生成AIを試着エンジンへと進化させる鍵です。人物の写真、衣服の写真、そして衣服部分のマスクデータを与えると、モデルはマスクされた領域のみ(画像インペインティングを参照)を再生成し、元の写真と違和感のない生地の質感、シワ、光の当たり具合を再現します。
ただし、生成には数秒の時間がかかり、高度なGPU演算が必要になるというトレードオフが存在します。そのため、拡散モデルベースのバーチャル試着は、リアルタイムの動画オーバーレイではなく、静止画で提供されています。
FAQ
疑問にお答えします。
バーチャル試着において、なぜGANの代わりに拡散モデルが採用されるようになったのですか?↓
初期のバーチャル試着研究ではGAN(敵対的生成ネットワーク)が使用されていましたが、拡散モデルの方が学習が安定しており、条件付けによる制御がしやすく、微細な質感を再現する能力に優れていることが実証されたためです。これらはすべて、衣服の表現において不可欠な要素です。