 Shopify
 WooCommerce
 API
Diffusionsmodell (Diffusion Model)
Eine generative KI-Architektur, die Bilder erstellt, indem sie lernt, einen schrittweisen Verrauschungsprozess umzukehren.
Was ist ein Diffusionsmodell?
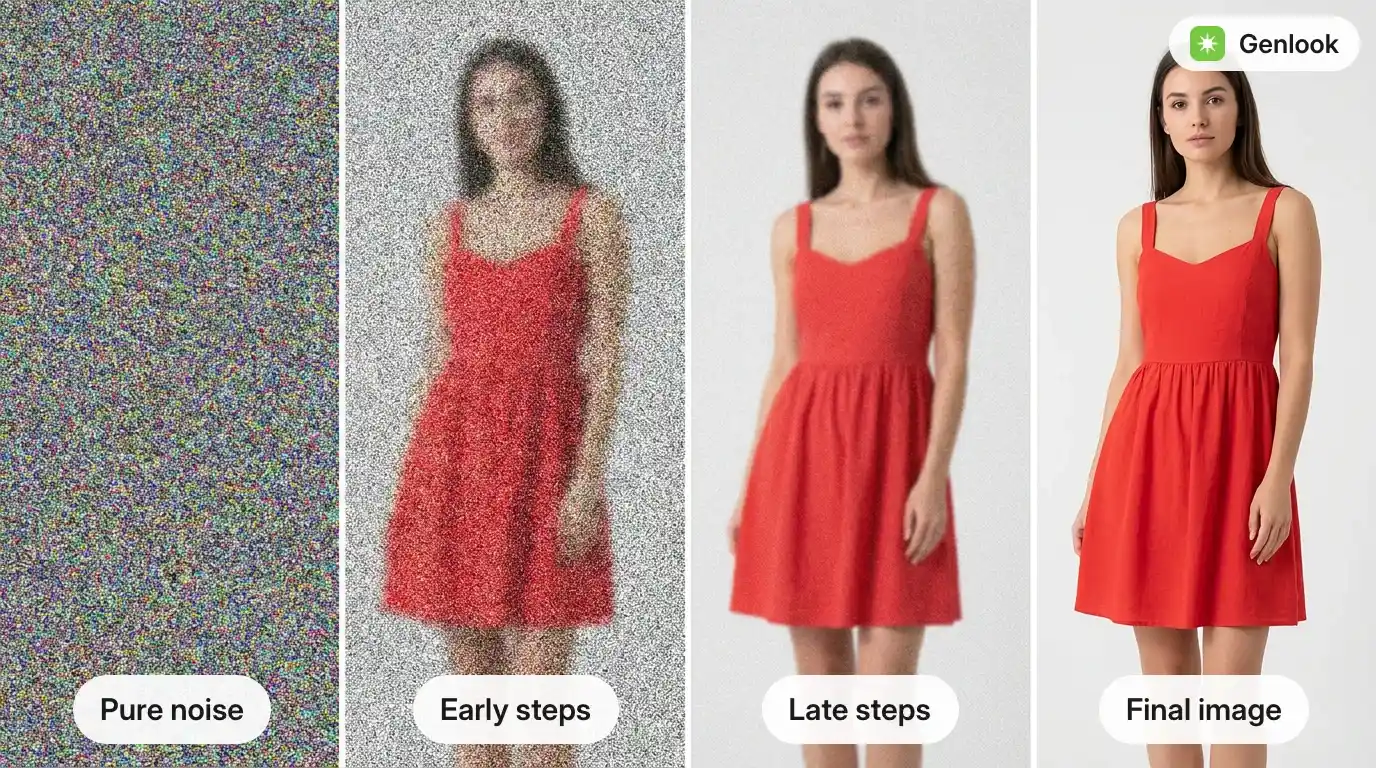
Ein Diffusionsmodell (Diffusion Model) ist eine generative KI-Architektur, die Bilder erzeugt, indem sie lernt, einen Prozess der Rauschzugabe (Verrauschung) umzukehren. Während des Trainings werden Bilder schrittweise durch zufälliges Rauschen zerstört, und das Modell lernt, jeden dieser Schritte rückgängig zu machen. Bei der Bilderzeugung (Generierung) beginnt es mit reinem Rauschen und entfernt dieses Rauschen Schritt für Schritt (Denoising), bis ein neues Bild entsteht. Gesteuert wird dieser Prozess durch Text-Prompts, Referenzbilder oder beides.
Diffusionsmodelle bilden die Grundlage der meisten modernen Bildgeneratoren, einschließlich der Kleidungsübertragungssysteme, die für die bildbasierte virtuelle Anprobe (Virtual Try-on) verwendet werden.
Wie es funktioniert
- Vorwärtsprozess (Training): Einem echten Bild wird in vielen kleinen Schritten Rauschen hinzugefügt, bis nur noch statisches Rauschen übrig ist.
- Erlernter Rückwärtsprozess: Das Modell wird darauf trainiert, für jeden Schritt den vorherigen, weniger verrauschten Zustand vorherzusagen.
- Generierung: Ausgehend von zufälligem Rauschen wird die erlernte Rauschunterdrückung wiederholt angewendet (in der Regel 20–50 Schritte), bis ein kohärentes Bild entsteht.
- Konditionierung: Bei jedem Schritt kann das Modell durch Eingaben wie ein Kleidungsbild, eine Körperhaltung oder eine Maske für den neu zu malenden Bereich gesteuert werden.
Rolle bei der virtuellen Anprobe
Die Konditionierung macht aus einem allgemeinen Bildgenerator eine Try-on-Engine: Wenn das Modell ein Foto einer Person, ein Foto eines Kleidungsstücks und eine Maske für die Kleidung erhält, regeneriert es nur den maskierten Bereich (siehe Image Inpainting). Dabei werden Stofftextur, Faltenwurf und Beleuchtung an das Originalfoto angepasst.
Der Kompromiss ist die Geschwindigkeit: Die Generierung dauert Sekunden und erfordert GPU-Rechenleistung. Aus diesem Grund liefert das auf Diffusion basierende Try-on statische Bilder und keine Live-Video-Overlays.
FAQ
Deine Fragen, beantwortet.
Warum haben Diffusionsmodelle GANs beim Try-on abgelöst?↓
Frühere Forschungsarbeiten zur virtuellen Anprobe nutzten GANs, aber Diffusionsmodelle erwiesen sich als stabiler im Training, kontrollierbarer durch Konditionierung und besser in der Reproduktion feiner Texturen. All dies ist für Kleidung entscheidend.