 Shopify
 WooCommerce
 API
扩散模型(Diffusion Model)
一种通过学习逆转逐步加噪过程来生成高质量图像的生成式 AI 架构。
什么是扩散模型?
**扩散模型(Diffusion Model)**是一种生成式 AI 架构,其核心机制在于学习逆转逐步加噪的过程。在训练阶段,算法会将随机噪声一步步添加到图像中直至完全破坏原有画面,同时让模型学会如何撤销每一步的噪声。在生成阶段,模型则从纯噪声出发,在文本提示词、参考图像或二者的引导下逐步去噪,最终渲染出全新的逼真图像。
目前绝大多数主流的顶尖图像生成系统都以扩散模型为基石,其中也包括驱动图像级虚拟试衣的服装迁移(garment transfer)技术。
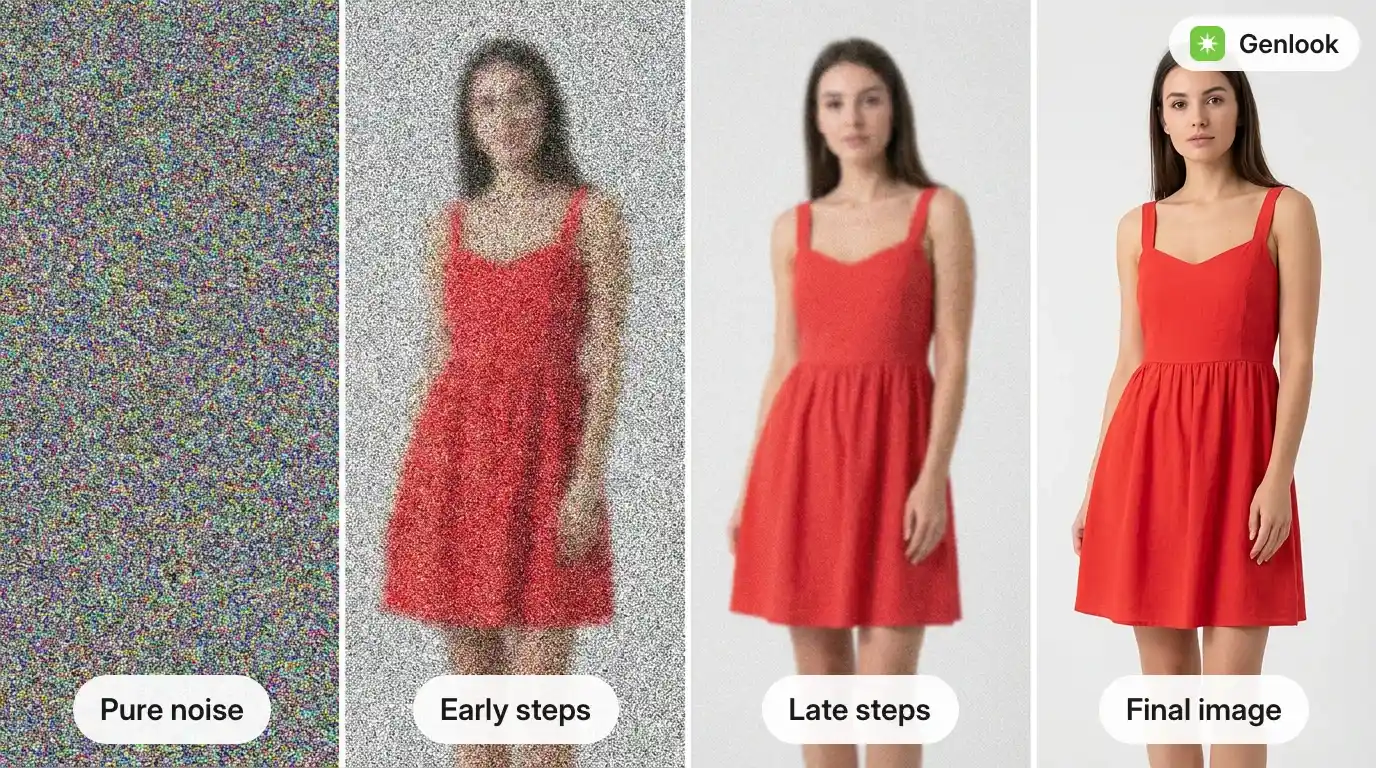
工作原理解析
- 前向加噪过程(训练阶段):算法分多步向真实图像连续添加微量噪声,直到画面彻底变成杂乱的无序噪点。
- 逆向学习去噪:训练模型在每个步长中精准预测前一步噪声较少的状态。
- 采样生成阶段:以纯随机噪声为起点,模型反复执行学到的去噪步骤(通常为 20 到 50 步),直至复原出清晰协调的图像。
- 条件控制(Conditioning):在去噪的每一步中,模型都可以引入外部引导信号,例如服装图样、人体姿态关键点或需要重新绘制的局部蒙版。
扩散模型在虚拟试穿中的应用
条件控制机制正是将通用图像生成器转化为专业试穿引擎的关键所在:只需输入人物原图、服装平铺图和服饰区域蒙版,模型便会仅针对蒙版覆盖区域进行重绘(参见图像局部修复),并自动还原与原图完美契合的面料纹理、自然褶皱与环境光影。
这种高质量呈现也伴随着一定的速度取舍:由于单次生成通常耗时数秒且依赖 GPU 算力支持,目前基于扩散模型的试衣方案主要输出高质量静态成片,而非实时视频层叠加。
常见问题
常见问题解答。
为什么虚拟试衣领域会转向扩散模型,逐步取代原有的 GAN?↓
早期的虚拟试穿研究大多基于生成对抗网络(GAN)。然而实践证明,扩散模型的训练过程更加稳定,在多条件引导下的可控性更强,且对于服饰细节与细腻面料质感的还原度更高。这些优势恰恰是服装展示最核心的诉求。