
 Shopify
 WooCommerce
2026 年 9 月 20 日,阿里巴巴的 Qwen 團隊開源了 Qwen-Image-2.1。這是一款 7B 參數的圖像模型,將生成與編輯功能整合於單一流程中,最多可接收 10 張參考圖片,並明確將虛擬試穿列為目標應用場景。
我們使用了八組測試各種引擎時常用的「人物與服裝」配對進行實測,並將結果與目前市面上最普及的商業方案之一 —— Google Vertex AI 的虛擬試穿模型進行比較。我們維持相同的照片、相同的提示詞流程,且未經任何微調。
Qwen-Image-2.1 是什麼?
Qwen-Image-2.1 將先前的三個模型(負責生成的 Qwen-Image、負責編輯的 Qwen-Image-Edit、負責透明度的 Qwen-Image-Layered)整合為單一模型。
- 生成模組具備 7B 參數(採用 32 層單流 DiT 架構)。Qwen3-VL 8B 則負責解讀提示詞與輸入圖像。
- **單次編輯最多支援 10 張參考圖。**根據發布頁面所述:「在虛擬試穿應用中,可將五種輸入(模特兒、服裝、鞋子、包包及帽子)組合成一套完整的穿搭。」
- **局部編輯功能。**無論是圈選區域、塗抹覆蓋或是輸入獨立遮罩,模型都能精準針對指定區域進行修改。
- 高度還原人物與商品是其訓練重點:編輯前後人臉保持不變,且能忠實保留商品的「文字、紋理與形狀」。
- **原生支援透明度。**可根據提示詞輸出 RGBA 圖像,並能從照片中提取主體生成透明圖層。
- **高效推論。**輸入的圖像與指令只需編碼一次,即可快取供後續每次降噪步驟使用;因此,即使輸入十張參考圖,其每步的運算成本也與單張參考圖相差無幾。
在團隊自家的 Qwen-Image-Bench 基準測試中,該模型得分為 60.28,在 29 個模型中名列第七。排在其前面的六款皆為閉源模型(GPT Image 2.5 以 67.01 居首)。若僅比較開源權重模型,它則以極大優勢穩居第一。
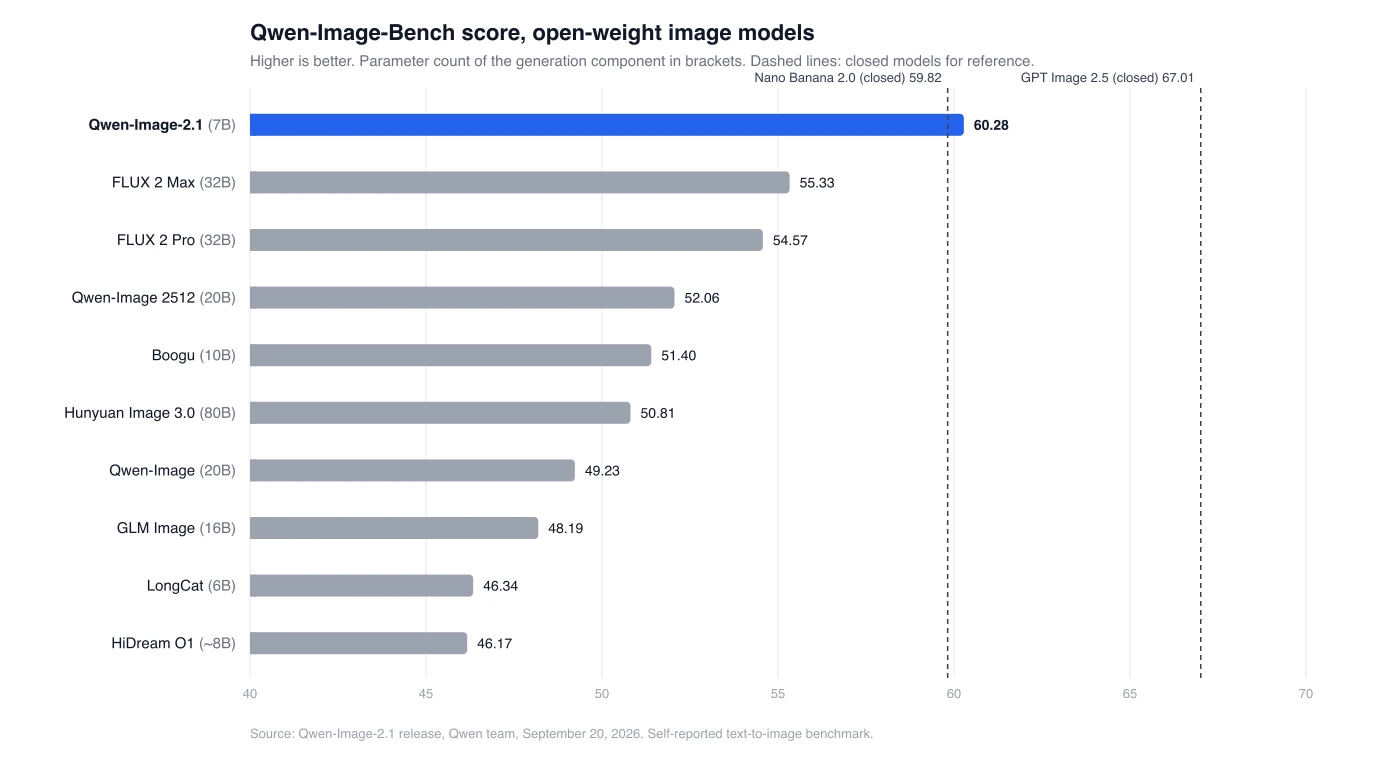
需注意的是,這是一項自評的基準測試,且主要評估的是生成能力而非編輯能力。模型權重已發布至 Hugging Face 與 ModelScope,並在發布首日即獲得 Diffusers、ComfyUI、vLLM-Omni 及 SGLang 的支援。
其採用 Qwen 研究授權(Qwen Research License),明訂「僅限非商業用途」。若需商業使用,必須另外與阿里巴巴簽署協議。更多詳情請見下文。
虛擬試穿效果如何?
表現出色,且完全支援零樣本(zero-shot)生成。
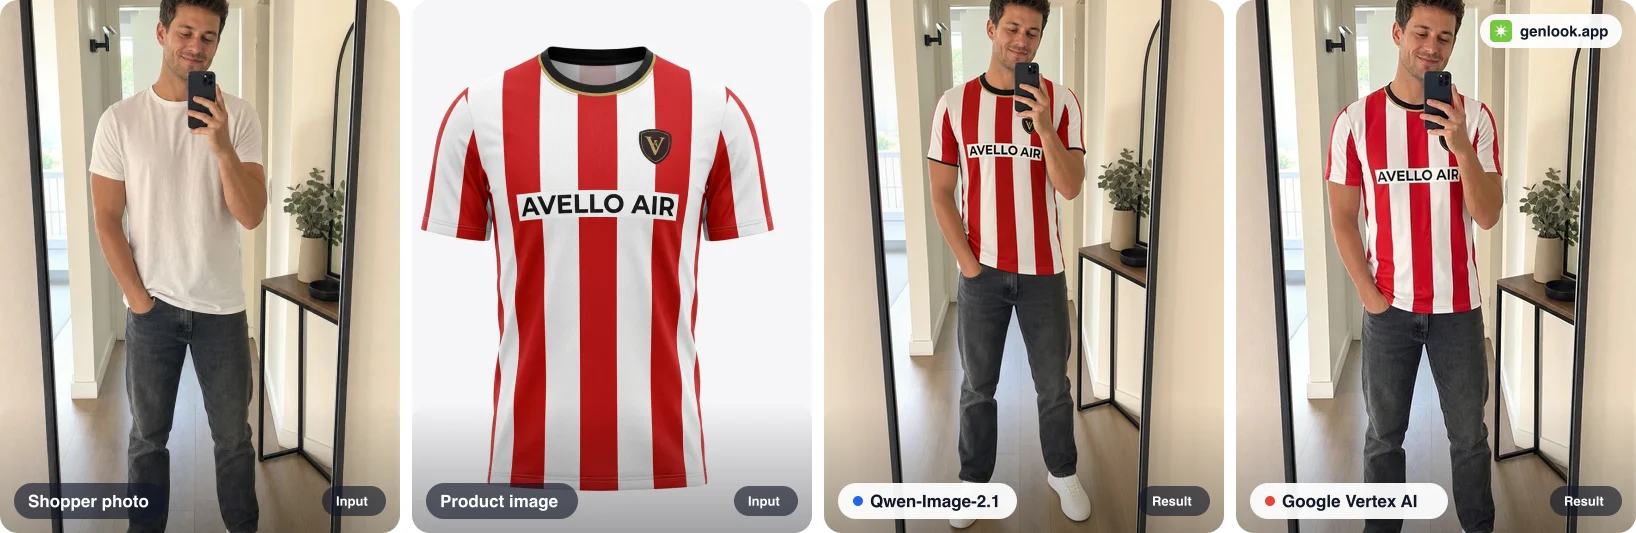
測試設定:我們從公開的試穿範例中挑選了八組,每組皆包含一張對鏡自拍照,以及一張商家上架用的商品圖(平拍或模特兒實穿圖)。Qwen-Image-2.1 在 Comfy Cloud 上以 16 步執行;Vertex AI 則透過其 API 呼叫。兩者採用相同的提示詞流程,未使用 LoRA,也無任何後製處理。以下各組對比圖由左至右依序為:消費者照片、商品圖、Qwen-Image-2.1 結果、Google Vertex AI 結果。
文章開頭的足球衣即為文字保留能力的測試。兩款模型皆成功保留了贊助商標誌及隊徽的清晰度與位置,且都未改變消費者的手部、手機或背景。
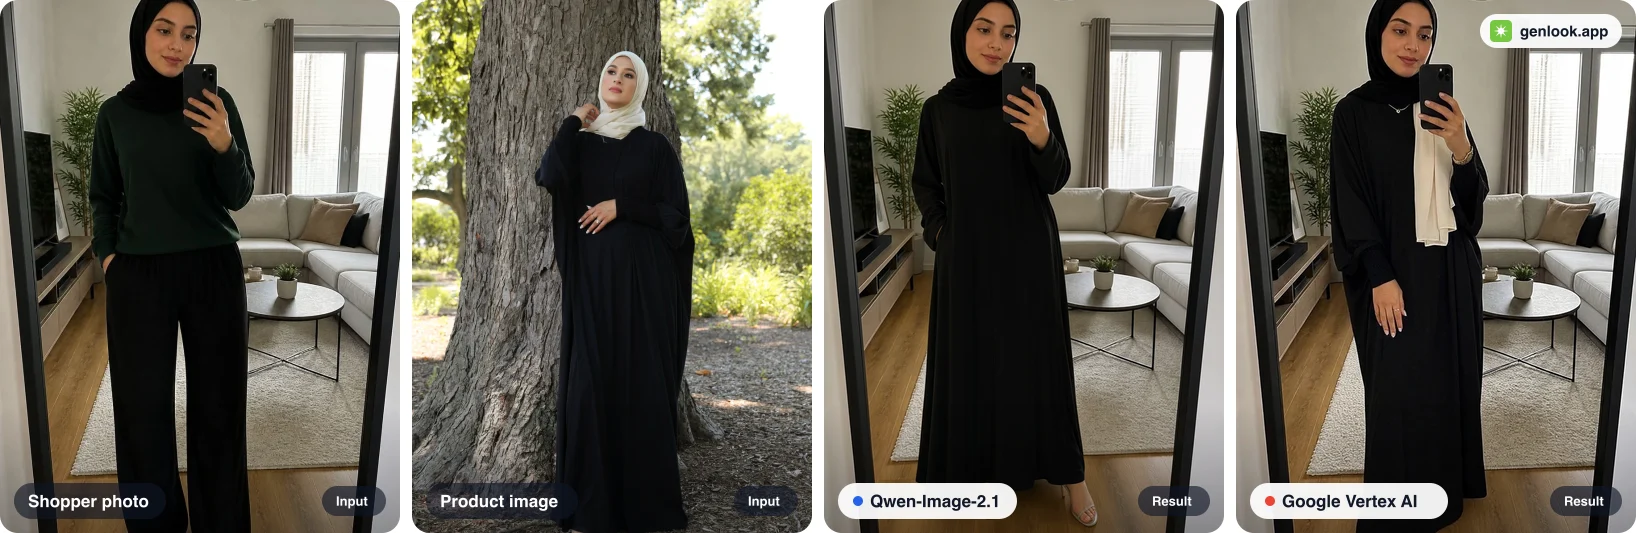
**Qwen 表現較佳之處。**在這張罩袍商品圖中,模特兒搭配了一條米色圍巾。Vertex AI 將圍巾連同服裝一併生成;而 Qwen 則精準地只替換了罩袍,未帶入多餘配件。
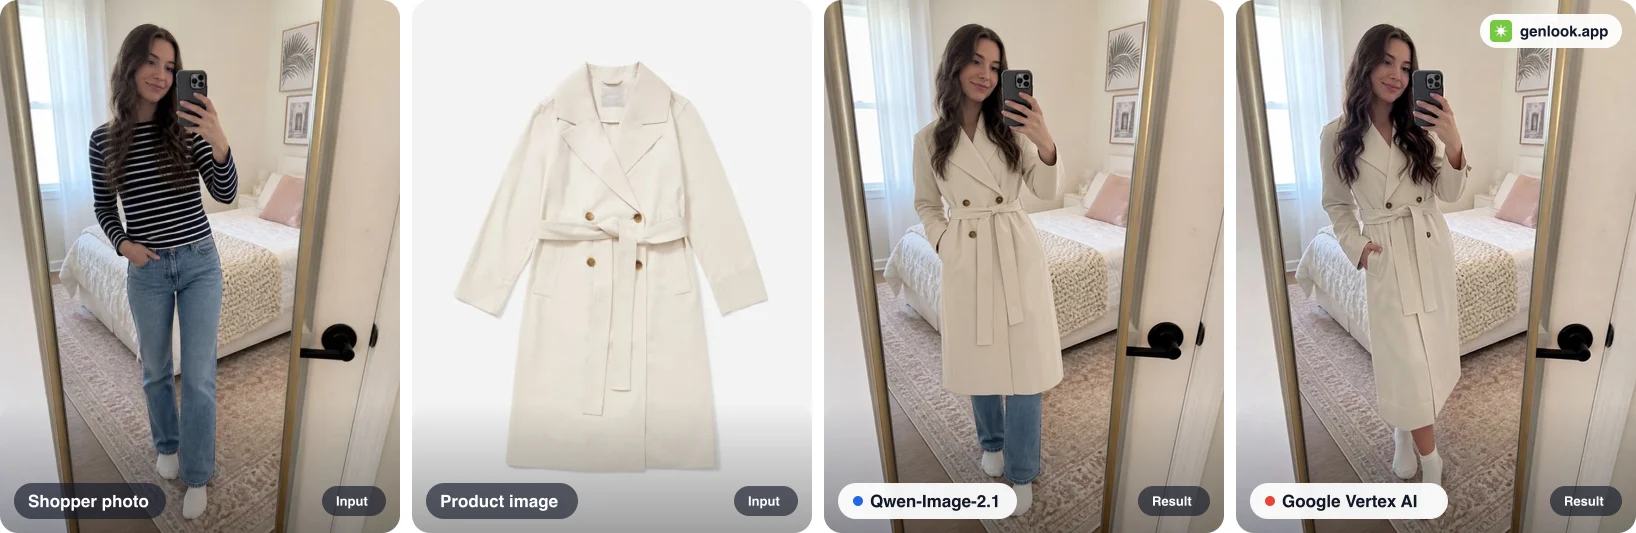
**Qwen 表現較弱之處。**原商品圖為及小腿中段長度。Vertex AI 成功保留了該長度,Qwen 卻將其縮短至膝蓋。不過,兩者在腰帶、開襟與翻領的細節處理上皆十分到位。在長版服飾的下擺長度上,Qwen 確實較易失準,這點在另一套多層次長洋裝的測試中也再次得到印證。
至於其餘五組(碎花中長裙、螢光連帽衫、兩截式紗麗、大尺碼長洋裝、蕾絲婚紗),兩款模型表現難分軒輊。雙方皆精準呈現了紗麗的上衣與邊飾,完美還原了中長裙的印花比例,且都未對人臉造成任何改變。
Qwen-Image-2.1 與 Google Vertex AI 試穿效果比較
| Qwen-Image-2.1 (Comfy Cloud) | Google Vertex AI 虛擬試穿 | |
|---|---|---|
| 完成組數 | 8 / 8 | 8 / 8 |
| 試穿中位數時間 | 9.9 秒 | 9.3 秒 |
| 單次試穿成本 | 約 0.005 美元 (GPU 時數) | 0.06 美元 (定價) |
| 並排畫質對比 | 6 組平手,1 組勝出,1 組落敗 | 6 組平手,1 組勝出,1 組落敗 |
| 權重狀態 | 開源,可微調 | 封閉 API |
| 授權條款 | 僅限研究,商業用途需協議 | 商業授權 |
Qwen 的執行時間包含了 Comfy Cloud 上約 3 秒的排隊時間。Qwen 的成本僅計算模型的 GPU 運算時間;一次完整的試穿請求還需包含服飾分類、提示詞建構與品質檢測等流程。
潛在限制
**授權問題。**Qwen-Image-2.1 採用 Qwen 研究授權協議,有別於 Qwen-Image-Edit-2511 所採用的 Apache 2.0。該授權明訂「僅限非商業用途」(定義為研究或評估),商業用戶需另行向阿里巴巴申請授權。在網店上放置試穿按鈕即屬商業行為;自行託管也同樣需要取得協議。
**兩個明顯弱點。**長版服飾的下擺長度易失準,以及多層次商品的部分配件易遺失。這兩者皆為系統性偏差,正是 LoRA 發揮作用的最佳時機。對於 7B 規模的模型,使用單張 GPU 訓練一個適配器只需數小時。ModelScope 的 DiffSynth-Studio 從發布首日即支援 2.1 的 LoRA 訓練,且 ComfyUI 也能透過標準節點載入適配器。訓練資料只需將模特兒實穿圖與對應的平拍照配對即可,而這通常是時尚型錄中現有的素材。透過在提示詞中指定服裝類別、開襟方式與長度,即可解決大部分的下擺失準問題;其餘細節則交由 LoRA 補足。
這對 Genlook 意味著什麼
Qwen-Image-2.1 是首款在我們的配對測試中,能夠以極低成本與商業試穿 API 達到同等水準的開源模型。我們目前正在升級 Genlook 的試穿管線,在原有服飾分類、提示詞建構與品質檢測的基礎上,針對其優勢場景導入該模型,確保每種商品都能獲得最佳的試穿效果。上述提到的兩個弱點,正是此次管線升級的首要攻堅目標。
對於開發者而言,Genlook 試穿 API 提供了支援所有商品類型的單一端點。一點額度即代表一次試穿:按量計費為 0.04 美元,月租方案則低至 0.015 美元起。套裝額度永不過期,新帳號註冊即贈免費額度。快速入門指南僅需四個步驟:建立商品、上傳照片、生成結果、獲取圖片。
總結
- **本次發布:**一款 7B 開源權重模型,單一模型即可完成生成、最多 10 張參考圖編輯及透明度處理。目前在團隊內部基準測試中表現最佳的開源模型。
- **試穿表現:**在 8 組零樣本實測中,有 6 組與 Google Vertex AI 打成平手。優勢在於能精準避開非服裝配件,弱勢則在於長版服飾的下擺長度掌握度較差。
- **成本考量:**單張圖片 GPU 運算成本約為 0.005 美元,遠低於 Vertex AI 的 0.06 美元。
- **潛在限制:**自行託管受限於非商業研究授權,且有兩個需透過 LoRA 修正的系統性弱點。
前往 platform.genlook.app 取得 API 金鑰 以體驗 Genlook 試穿 API,或為您的網店新增虛擬試穿功能。
常見問答