 Shopify
 WooCommerce
 API
ポーズ推定
画像や動画から人間の関節や特徴点の位置を検出するコンピュータービジョン技術。
ポーズ推定とは?
ポーズ推定は、画像や動画ストリーム内の人間の関節(肩、肘、手首、腰、膝、足首など)の位置を特定するコンピュータービジョン技術です。出力されるのはキーポイントの座標データであり、通常はこれらを結んで人物の姿勢を示すスケルトン(骨格)を形成します。
バーチャル試着システムにおいて、ポーズ推定は「この体はどのような姿勢か?」という問いに答える役割を果たします。このデータをもとに、衣服の配置場所、角度、サイズが決定されます。
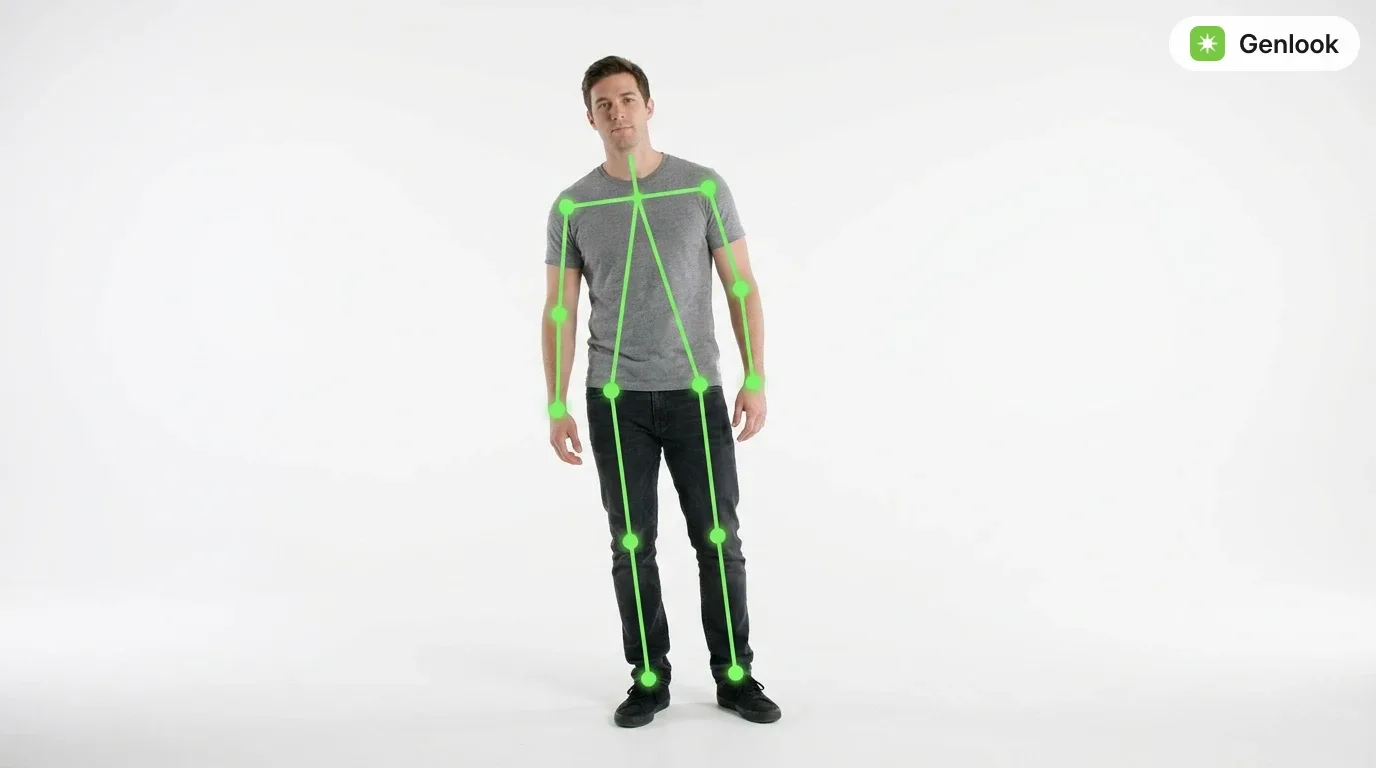
仕組み
- 人物検出: フレーム内の人物を特定します。
- キーポイント予測: ニューラルネットワークが17〜33箇所の関節座標を予測します。
- スケルトン構築: キーポイント同士を繋ぎ、姿勢や手足の角度をトラッキングする骨格構造を形成します。
- 時間的スムージング(動画のみ): フレーム間の予測を滑らかにし、ブレやちらつきを軽減します。
バーチャル試着における役割
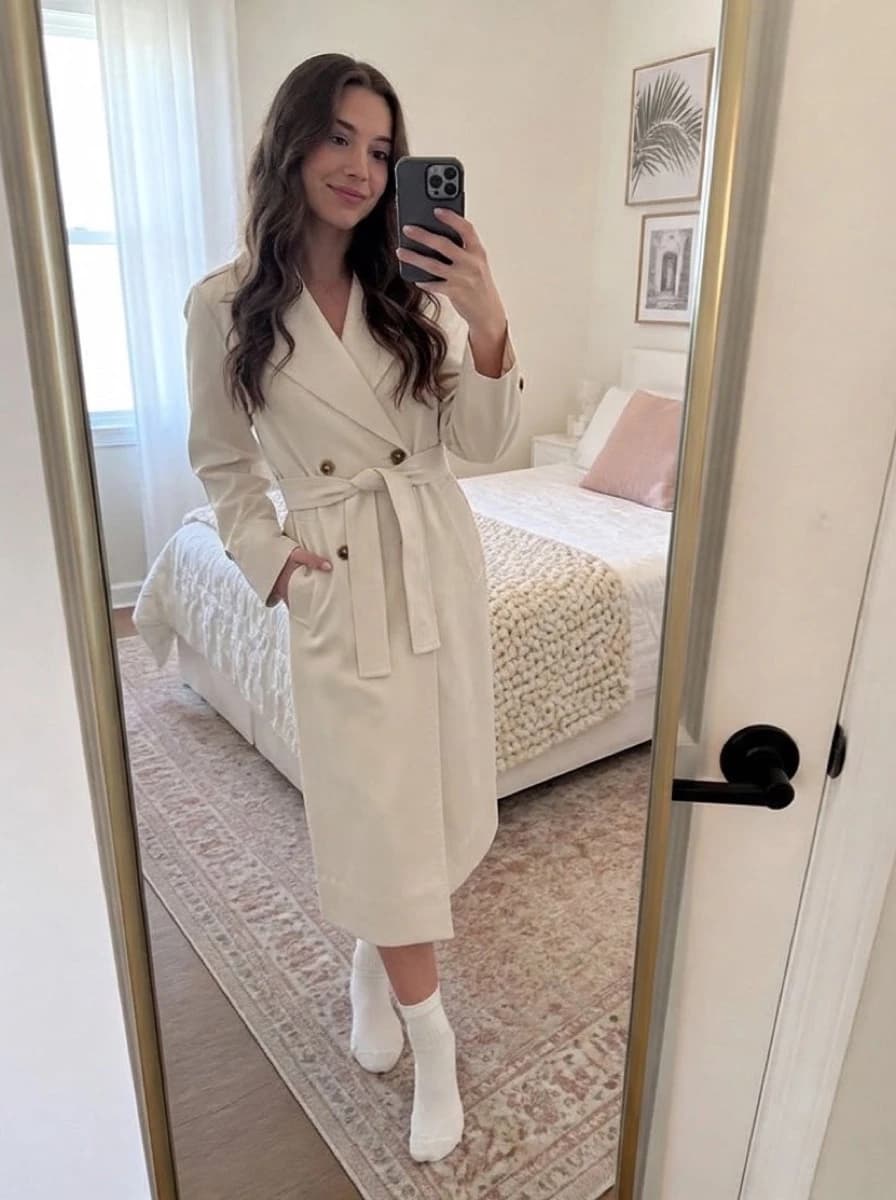
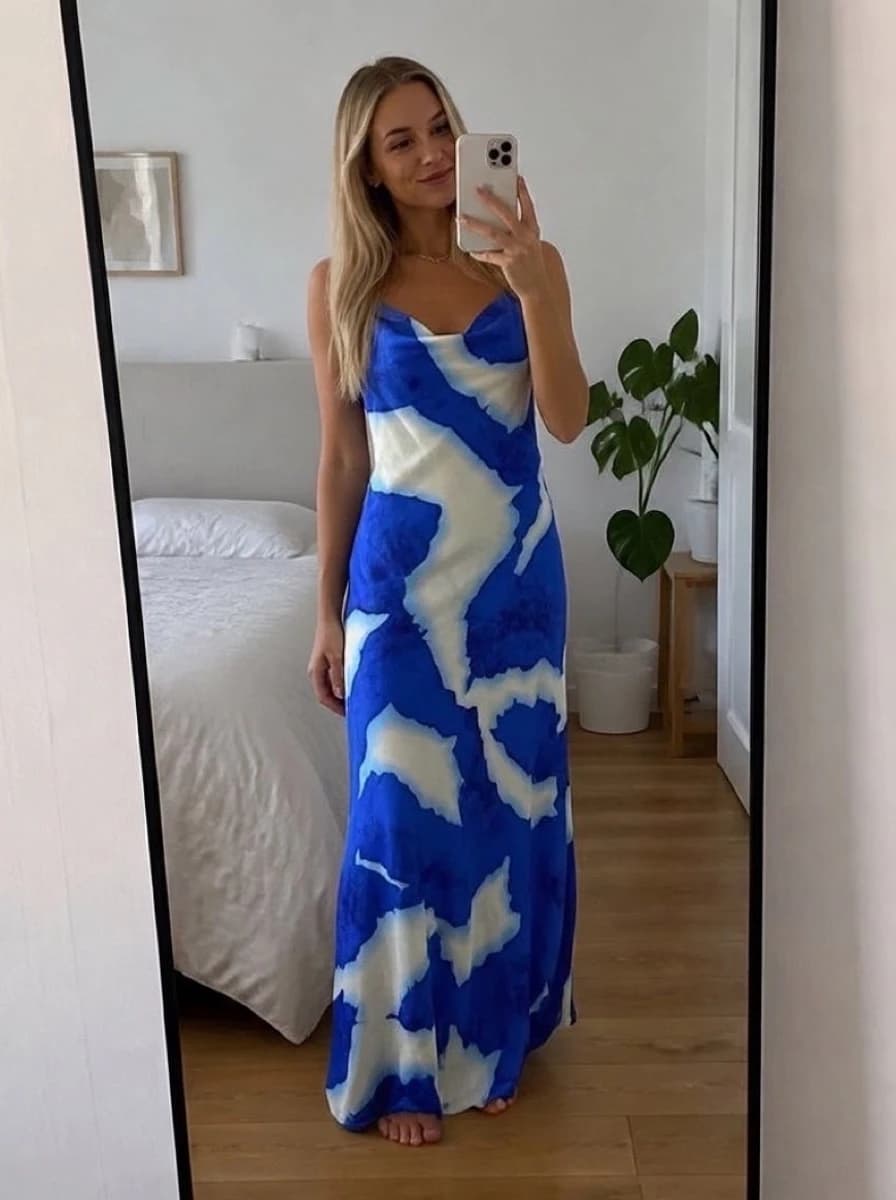
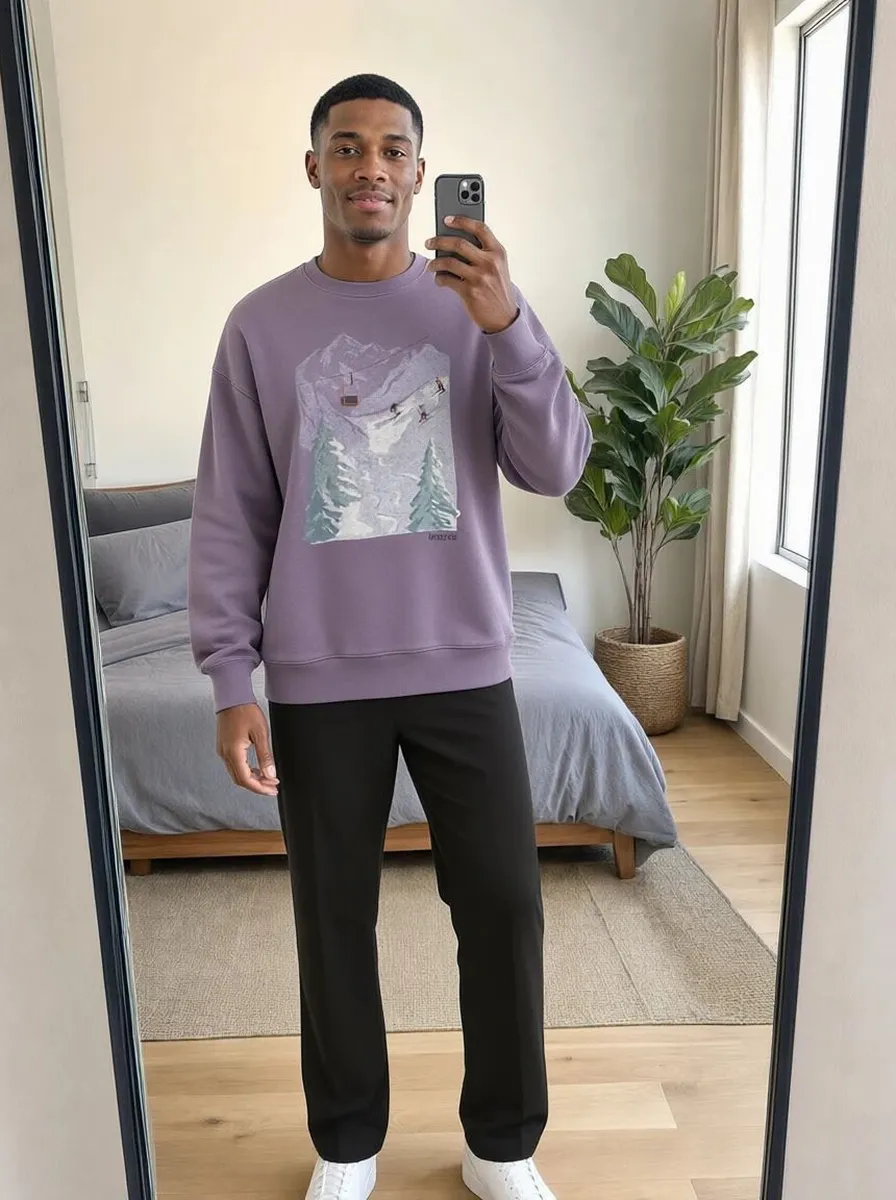
- 画像ベースの試着: 1枚の写真からポーズを推定し、衣服の合成をガイドします。これにより、袖が腕の動きに沿い、裾が適切な位置に収まります。
- ライブAR試着: フレームごとのポーズ推定により、動く体に合わせて3D商品(靴、時計など)を正確に配置します。
- 採寸: 関節の位置情報から体型バランスを推定し、3Dボディモデルの作成やサイズ推奨に活用します。
ポーズ推定が不正確な場合、ドレスの角度が不自然になったり、靴が足からズレたりするなど、合成結果に違和感が生じます。
FAQ
疑問にお答えします。
ポーズ推定はボディスキャンと同じですか?↓
いいえ、異なります。ポーズ推定は、通常の画像から2D(または2.5D)で関節の位置を検出する技術です。一方、ボディスキャンは体の表面の完全な3Dメッシュを構築するものであり、専用のハードウェアや複数アングルからの撮影が必要になります。