 Shopify
 WooCommerce
 API
擴散模型(Diffusion Model)
一種生成式 AI 架構,透過學習逆轉逐步加噪的過程來生成逼真圖像。
什麼是擴散模型?
**擴散模型(Diffusion Model)**是一種生成式 AI 架構,其核心概念是學習逆轉「加噪」過程來生成圖像。在訓練階段,原始圖像會被逐步加入隨機雜訊直到完全破壞,模型則學著一步步還原。而在實際生成時,模型從純雜訊出發,在文字提示、參考圖片或兩者的引導下逐步去噪,最終生成嶄新的清晰影像。
擴散模型是目前絕大多數頂尖影像生成技術的核心基礎,其中也包含應用於圖像虛擬試穿的服飾轉移(Garment Transfer)系統。
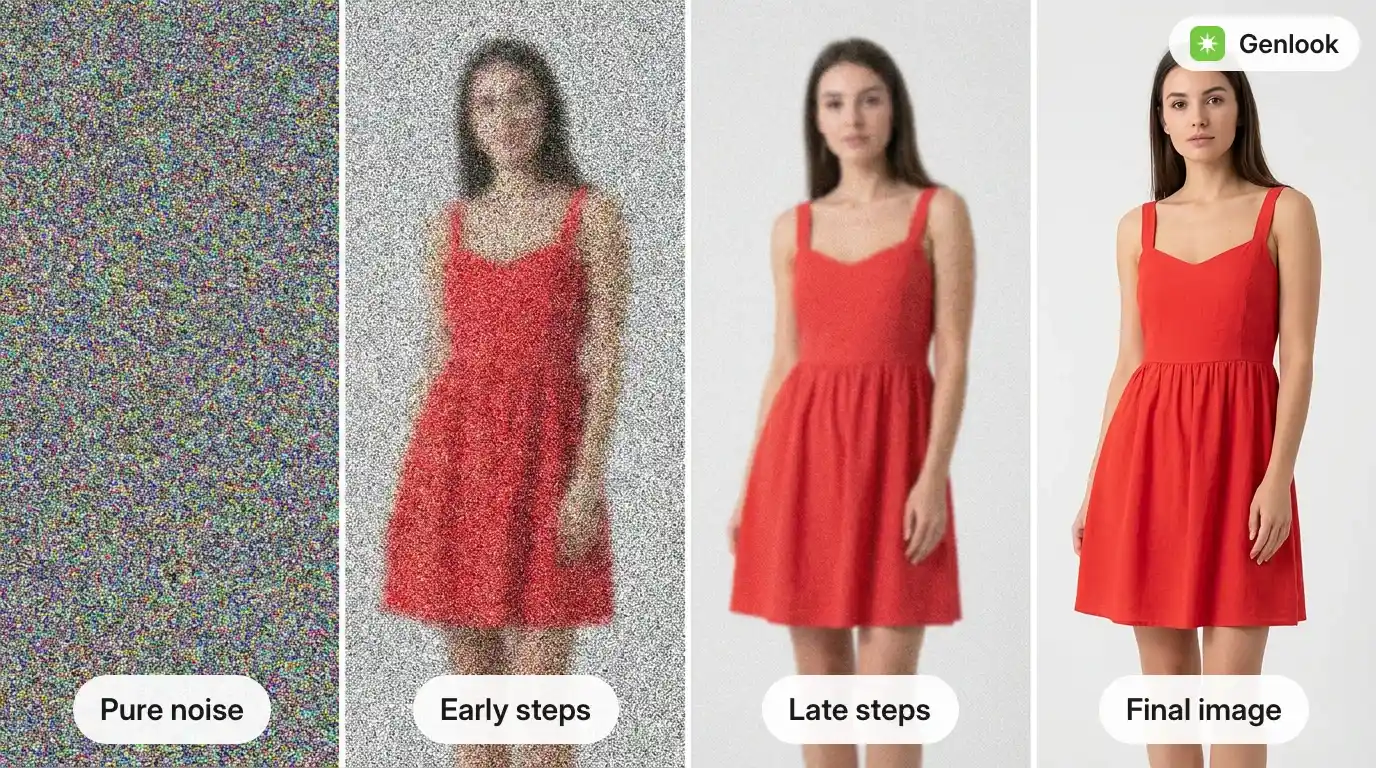
運作原理
- 前向過程(訓練階段):在真實圖像中分步加入微量雜訊,重複多次直到畫面只剩下雜訊雜訊點。
- 學習逆向過程:訓練模型在每個步驟中精準預測前一步雜訊較少的狀態。
- 影像生成:從隨機雜訊開始,反覆套用已學會的去噪步驟(通常為 20 至 50 步),直到生成結構完整的清晰圖像。
- 條件引導(Conditioning):在每個去噪步驟中,模型都能依據特定條件調整方向,例如服飾平拍圖、人體姿態或需重新繪製的遮罩區域。
在虛擬試穿中的應用
「條件引導」正是將通用影像生成器轉化為專屬虛擬試穿引擎的關鍵:只要提供人物照片、服裝照片與衣物遮罩,模型就能針對遮罩區域進行局部重繪(詳見影像修復 Image Inpainting),並自動重現符合原圖光影、垂墜皺褶與布料細節的真實質感。
這項技術的主要權衡在於生成速度:每次運算需要數秒時間並依賴 GPU 算力支援,因此現階段以擴散模型為基礎的試穿體驗主要產出高品質靜態影像,而非即時視訊濾鏡。
常見問答
為您解答疑問。
為什麼擴散模型在虛擬試穿領域會取代 GAN?↓
早期的虛擬試穿研究多採用生成對抗網絡(GAN),但擴散模型已被證實訓練過程更穩定、透過條件引導的可控性更高,且更能細緻還原衣物布料的紋理細節,而這些特性正是服裝穿搭呈現中最不可或缺的關鍵。