
 Shopify
 WooCommerce
Am 20. September 2026 hat das Qwen-Team von Alibaba Qwen-Image-2.1 als Open Source veröffentlicht. Es ist ein 7B-Bildmodell, das in einer einzigen Pipeline generiert und bearbeitet, bis zu 10 Referenzbilder verarbeitet und Virtual Try-On als primären Anwendungsfall nennt. 0
Wir haben es mit den acht Personen-und-Kleidungs-Paaren getestet, die wir für jede Engine verwenden, und zwar im direkten Vergleich mit Googles Virtual Try-On-Modell auf Vertex AI – einer der gängigsten kommerziellen Optionen. Gleiche Fotos, gleiche Prompt-Pipeline, kein Fine-Tuning.
Was ist Qwen-Image-2.1?
Qwen-Image-2.1 ersetzt drei frühere Modelle (Qwen-Image für die Generierung, Qwen-Image-Edit für die Bearbeitung, Qwen-Image-Layered für Transparenz) durch einen einzigen Checkpoint.
- 7B Parameter in der Generierungskomponente (32 Single-Stream DiT-Schichten). Qwen3-VL 8B liest den Prompt und die Eingabebilder.
- Bis zu 10 Referenzbilder in einer Bearbeitung. Aus den Release-Notes: „Für Virtual Try-On können fünf Eingaben (ein Model, Kleidung, Schuhe, eine Tasche und ein Hut) zu einem kompletten Outfit kombiniert werden.“
- Regionale Bearbeitung. Kreisen Sie einen Bereich ein, malen Sie darüber oder übergeben Sie eine separate Maske, und nur dieser Bereich ändert sich.
- Detailtreue für Menschen und Produkte ist ein erklärtes Trainingsziel: Gesichter bleiben bei Bearbeitungen gleich, „Text, Texturen und Form“ von Produkten bleiben erhalten.
- Native Transparenz. RGBA-Ausgabe durch einen Prompt und Freistellung des Motivs aus einem Foto als transparente Ebene.
- Effiziente Inferenz. Eingabebilder und Anweisungen werden einmal codiert und für jeden Denoising-Schritt zwischengespeichert, sodass eine Bearbeitung mit zehn Referenzen pro Schritt ungefähr das Gleiche kostet wie mit einer einzigen Referenz.
Im teaminternen Qwen-Image-Bench erreicht es einen Score von 60,28 und belegt damit Platz sieben von 29 Modellen. Die sechs davor platzierten Modelle sind nicht öffentlich (GPT Image 2.5 führt mit 67,01). Unter den Open-Weight-Modellen liegt es mit großem Abstand auf dem ersten Platz.
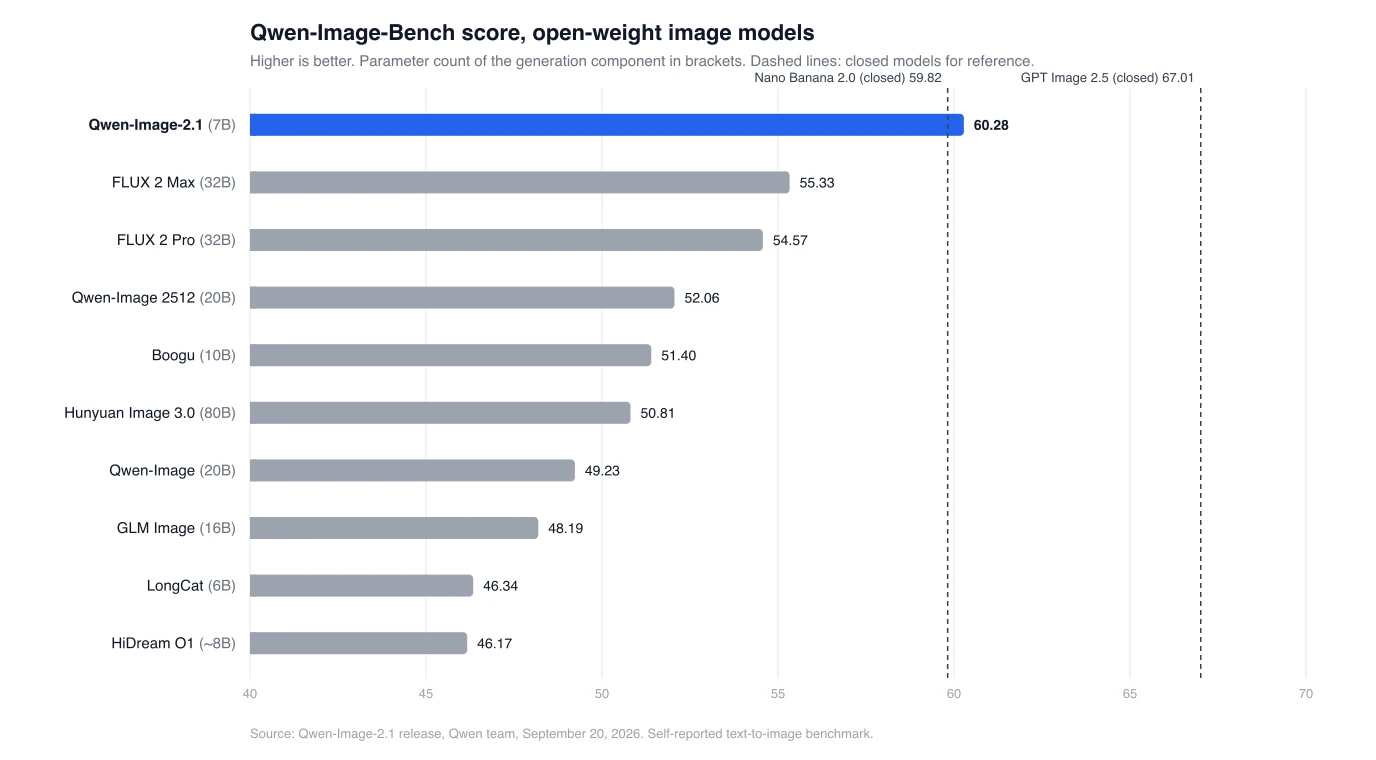
Dies ist ein selbst durchgeführter Benchmark, der die Generierung und nicht die Bearbeitung misst. Die Gewichte liegen auf Hugging Face und ModelScope bereit, mit Day-Zero-Support in Diffusers, ComfyUI, vLLM-Omni und SGLang.
Die Lizenz ist die Qwen Research License, „nur für nicht-kommerzielle Zwecke“. Für die kommerzielle Nutzung ist eine separate Vereinbarung mit Alibaba erforderlich. Mehr dazu weiter unten.
Funktioniert es für Virtual Try-On?
Ja, Zero-Shot.
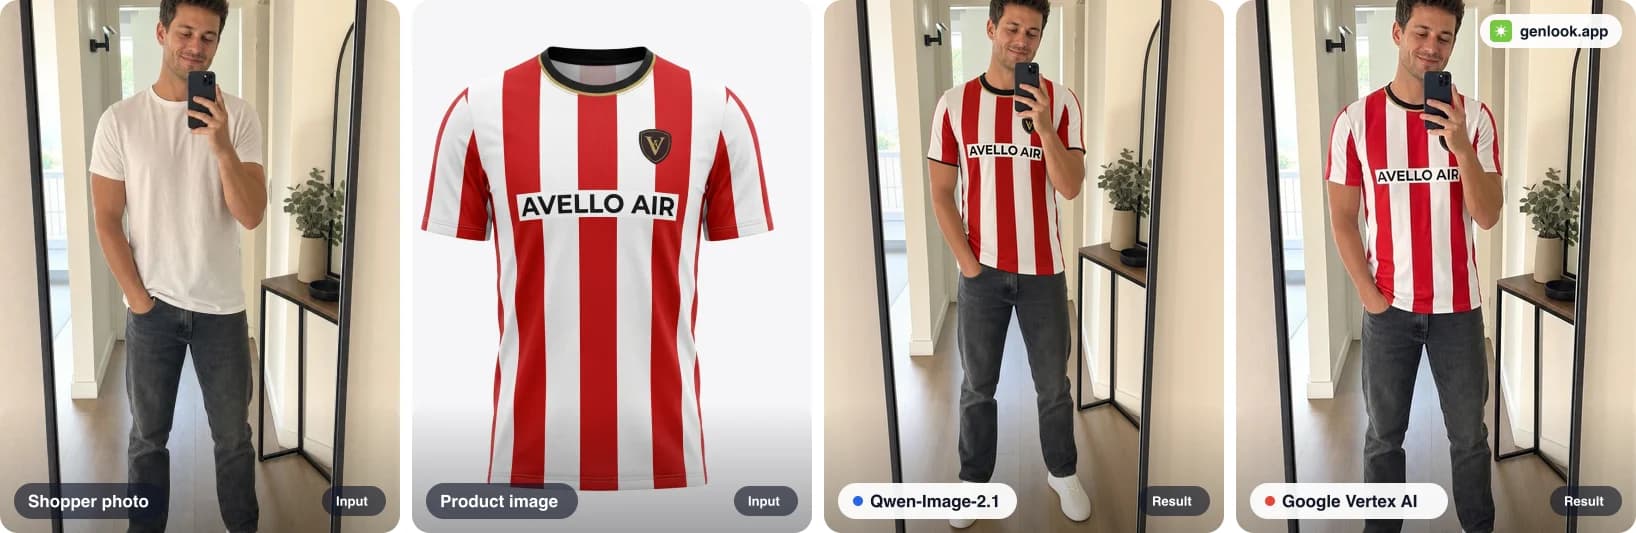
Setup: Acht Paare aus unseren öffentlichen Try-On-Beispielen, jeweils ein Spiegel-Selfie plus das Produktbild, so wie ein Händler es hochladen würde (ein flacher Packshot oder ein Foto am Model). Qwen-Image-2.1 lief in der Comfy Cloud mit 16 Schritten. Vertex AI lief über seine API. Beide durchliefen dieselbe Prompt-Pipeline, ohne LoRA und ohne Post-Processing. Jedes Panel zeigt von links nach rechts: Kundenfoto, Produktbild, Qwen-Image-2.1, Google Vertex AI.
Das Fußballtrikot oben im Beitrag ist der Text-Test. Beide Modelle halten den Sponsorenschriftzug und das Wappen lesbar und an der richtigen Stelle, und keines der beiden verändert die Hände, das Telefon oder den Hintergrund der Kundin.
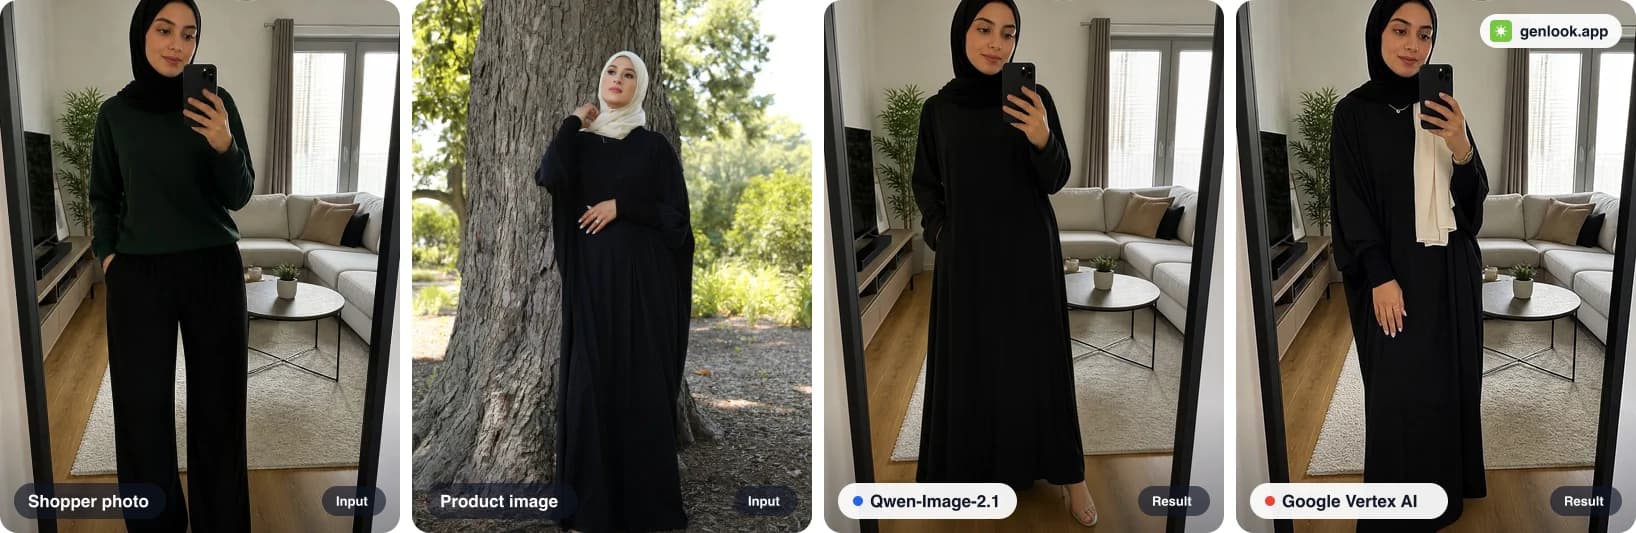
Wo Qwen besser abschneidet. Die Abaya wird an einem Model fotografiert, das einen cremefarbenen Schal trägt. Vertex hat den Schal zusammen mit dem Kleidungsstück übernommen. Qwen hat nur die Abaya geändert und sonst nichts.
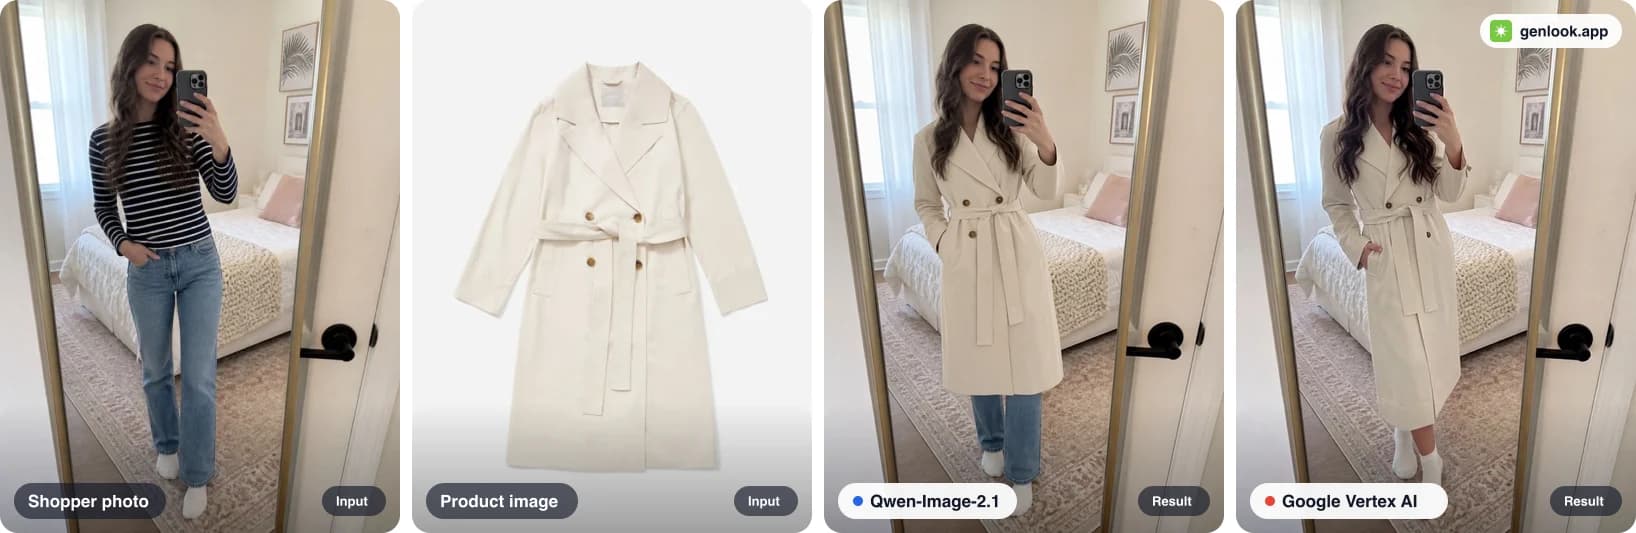
Wo Qwen schwächer ist. Der Packshot ist wadenlang. Vertex behält diese Länge bei, Qwen stoppt am Knie. Gürtel, Verschluss und Revers sind bei beiden richtig. Die Saumlänge bei langen Kleidungsstücken war der einzige durchgängige Fehler, der auch bei einem gestuften Maxikleid wieder auftrat.
Die anderen fünf Paare (ein florales Midi-Kleid, ein Neon-Hoodie, ein zweiteiliger Sari, ein Plus-Size-Maxikleid, ein Spitzenbrautkleid) konnten wir qualitativ nicht trennen. Beide übernahmen die Bluse und die Bordüre des Saris, beide trafen die Skalierung des Musters beim Midi-Kleid richtig, keines der beiden veränderte ein Gesicht.
Qwen-Image-2.1 vs. Google Vertex AI Try-On
| Qwen-Image-2.1 auf Comfy Cloud | Google Vertex AI Virtual Try-On | |
|---|---|---|
| Abgeschlossene Paare | 8 von 8 | 8 von 8 |
| Median-Dauer pro Try-On | 9,9 s | 9,3 s |
| Kosten pro Try-On | ca. $0,005 (GPU-Zeit) | $0,06 (Listenpreis) |
| Qualität im Direktvergleich | 6 Unentschieden, 1 besser, 1 schlechter | 6 Unentschieden, 1 besser, 1 schlechter |
| Gewichte | offen, können fine-getuned werden | geschlossene API |
| Lizenz | nur Forschung, kommerziell nach Vereinbarung | kommerziell |
Die Zeit von Qwen beinhaltet etwa drei Sekunden Warteschlange in der Comfy Cloud. Die Qwen-Kosten beziehen sich nur auf die GPU-Zeit für das Modell; eine vollständige Try-On-Anfrage umfasst außerdem die Klassifizierung von Kleidungsstücken, die Prompt-Erstellung und Qualitätsprüfungen.
Der Haken
Lizenz. Qwen-Image-2.1 wird unter dem Qwen Research License Agreement ausgeliefert, nicht unter Apache 2.0 wie Qwen-Image-Edit-2511. Die Lizenzdatei gewährt die Nutzung „nur für nicht-kommerzielle Zwecke“, definiert als Forschung oder Evaluierung, und weist kommerzielle Nutzer an, eine Lizenz bei Alibaba zu beantragen. Ein Try-On-Button in einem Shop ist eine kommerzielle Nutzung. Auch für Self-Hosting ist diese Vereinbarung erforderlich.
Die zwei Schwachpunkte. Die Saumlänge bei langen Kleidungsstücken und weggelassene Nebenteile bei einigen mehrteiligen Produkten. Beide Fehler sind systematisch – genau dafür ist ein LoRA da. Mit 7B trainiert ein Adapter auf einer einzelnen GPU in wenigen Stunden. DiffSynth-Studio auf ModelScope unterstützt LoRA-Training für 2.1 vom ersten Tag an und ComfyUI lädt Adapter über seine Standard-Nodes. Die Trainingsdaten bestehen aus einem Model-Foto gepaart mit dem passenden Packshot, was Modekataloge ohnehin schon haben. Ein Prompt, der die Kategorie, den Verschluss und die Länge des Kleidungsstücks nennt, behebt die meisten Saumfehler bereits von selbst; ein LoRA deckt den Rest ab.
Was das für Genlook bedeutet
Qwen-Image-2.1 ist das erste offene Modell, das bei unseren Paaren die Parität mit einer kommerziellen Try-On-API erreicht – zu einem Bruchteil der Kosten pro Bild. Wir rüsten die Genlook-Try-On-Pipeline auf, um es dort einzusetzen, wo es stärker ist. Dies geschieht zusätzlich zur Kleidungsstückklassifizierung, Prompt-Erstellung und den Qualitätsprüfungen, die jedes Modell umgeben, damit jeder Produkttyp die beste verfügbare Try-On-Qualität erhält. Die beiden oben genannten Schwachpunkte sind die ersten Dinge, die wir bei der Pipeline-Arbeit in Angriff nehmen.
Für Entwickler ist die Genlook Try-On API der einzige Endpunkt für jeden Produkttyp. Ein Credit entspricht einem Try-On: $0,04 Pay-as-you-go oder ab $0,015 im Monatsabo. Paket-Credits verfallen nie, und neue Accounts starten mit Gratis-Credits. Der Quickstart besteht aus vier Aufrufen: Produkt erstellen, Foto hochladen, generieren, Ergebnis abrufen.
Zusammenfassung
- Das Release: Ein offenes 7B-Modell, das in einem Checkpoint generiert, mit bis zu 10 Referenzen bearbeitet und Transparenz handhabt. Bestes offenes Modell im teaminternen Benchmark.
- Beim Try-On: Zieht bei 6 von 8 Paaren Zero-Shot mit Googles Vertex AI-Modell gleich. Besser darin, Nicht-Kleidungsstücke in Ruhe zu lassen, schwächer bei der Saumlänge von langen Kleidungsstücken.
- Kosten: Etwa $0,005 GPU-Zeit pro Bild im Vergleich zu $0,06.
- Der Haken: Eine reine Forschungslizenz für Self-Hoster und zwei Schwachpunkte, die ein LoRA beheben sollte.
Holen Sie sich einen API-Key unter platform.genlook.app, um die Genlook Try-On API zu nutzen, oder fügen Sie Virtual Try-On zu Ihrem Shop hinzu.
FAQ