
 Shopify
 WooCommerce
Am 20. September 2026 hat das Qwen-Team bei Alibaba Qwen-Image-2.1 als Open-Source-Modell freigegeben. Es handelt sich um ein 7B-Bildmodell, das in einer einzigen Pipeline Bilder generiert und bearbeitet, bis zu 10 Referenzbilder verarbeiten kann und Virtual Try-On (die virtuelle Anprobe) als einen der Hauptanwendungsfälle nennt.
Wir haben es mit den acht Kombinationen aus Person und Kleidungsstück getestet, die wir für jede Engine verwenden, und zwar im direkten Vergleich mit dem Virtual-Try-On-Modell von Google auf Vertex AI – einer der meistgenutzten kommerziellen Optionen. Gleiche Fotos, gleiche Prompt-Pipeline, kein Fine-Tuning.
Was genau ist Qwen-Image-2.1?
Qwen-Image-2.1 ersetzt drei frühere Modelle (Qwen-Image für die Generierung, Qwen-Image-Edit für die Bearbeitung und Qwen-Image-Layered für Transparenz) durch ein einziges Checkpoint-Modell.
- 7B Parameter in der Generierungskomponente (32 Single-Stream DiT-Schichten). Qwen3-VL 8B liest dabei den Prompt und die Eingabebilder.
- Bis zu 10 Referenzbilder in einem Bearbeitungsschritt. Aus den Release-Notes: „Für Virtual Try-On lassen sich fünf Eingaben (Model, Kleidung, Schuhe, Tasche und Hut) zu einem kompletten Outfit kombinieren.“
- Regionale Bearbeitung. Bereich einkreisen, übermalen oder eine separate Maske übergeben, und nur dieser spezifische Bereich wird geändert.
- Detailtreue bei Personen und Produkten ist ein erklärtes Trainingsziel: Gesichter bleiben bei Bearbeitungen erhalten, bei Produkten werden „Text, Texturen und Form“ exakt beibehalten.
- Native Transparenz. RGBA-Ausgabe direkt aus einem Prompt sowie die Freistellung von Motiven aus einem Foto als transparente Ebene.
- Effiziente Inferenz. Eingabebilder und Anweisungen werden einmalig kodiert und für jeden Denoising-Schritt zwischengespeichert. So kostet ein Edit mit zehn Referenzbildern pro Schritt etwa genauso viel Rechenleistung wie einer mit nur einer einzigen Referenz.
Im teaminternen Qwen-Image-Bench erreicht es einen Wert von 60,28 und belegt damit Platz 7 von 29 Modellen. Die sechs Modelle davor sind geschlossen (GPT Image 2.5 führt mit 67,01). Unter den Modellen mit offenen Gewichten liegt es jedoch mit großem Abstand auf Platz eins.
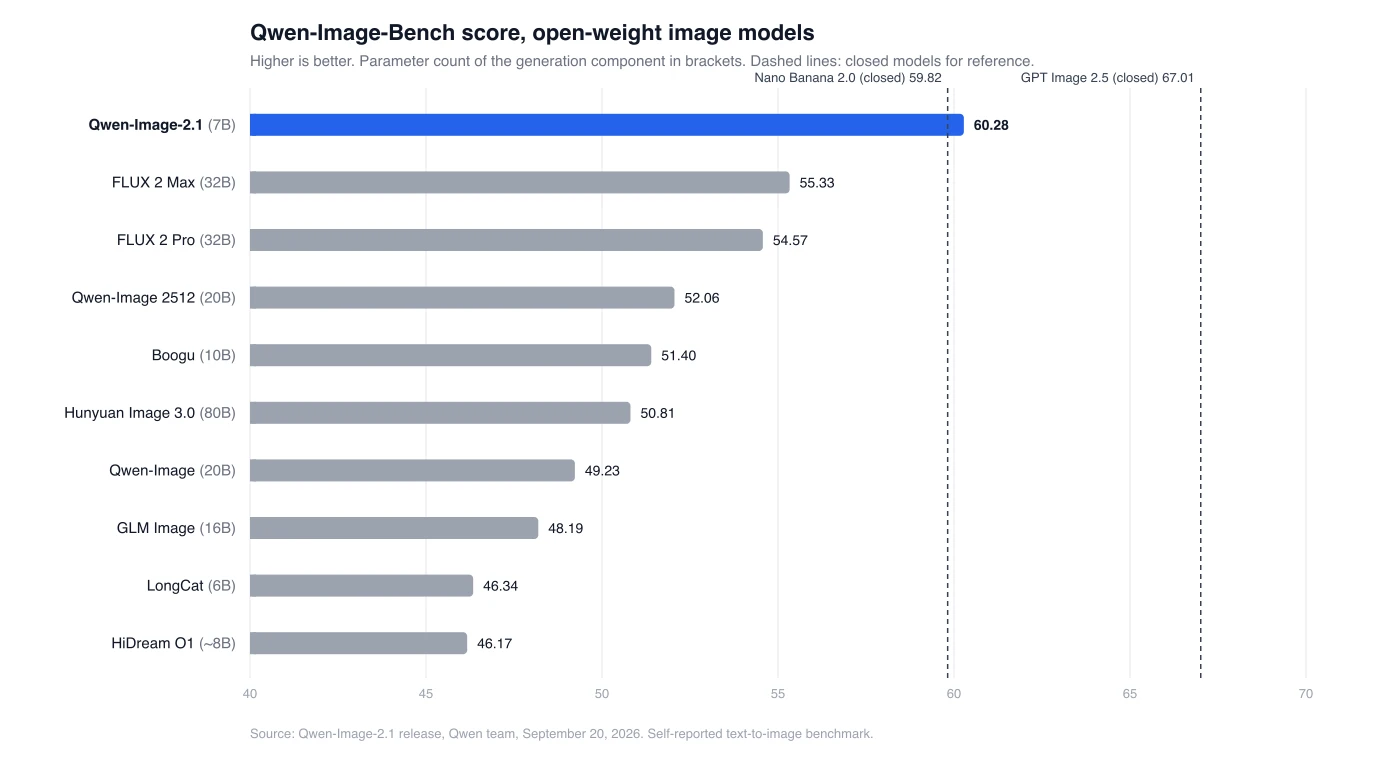
Hierbei handelt es sich um einen selbstberichteten Benchmark, der zudem die Generierung misst und nicht die Bildbearbeitung. Die Modellgewichte sind auf Hugging Face und ModelScope verfügbar, mit sofortiger (Day-Zero) Unterstützung in Diffusers, ComfyUI, vLLM-Omni und SGLang.
Die Lizenz ist die Qwen Research License, also „nur für nicht-kommerzielle Zwecke“. Für die kommerzielle Nutzung ist eine separate Vereinbarung mit Alibaba erforderlich. Mehr dazu weiter unten.
Funktioniert das Modell für Virtual Try-On?
Ja, und zwar Zero-Shot.
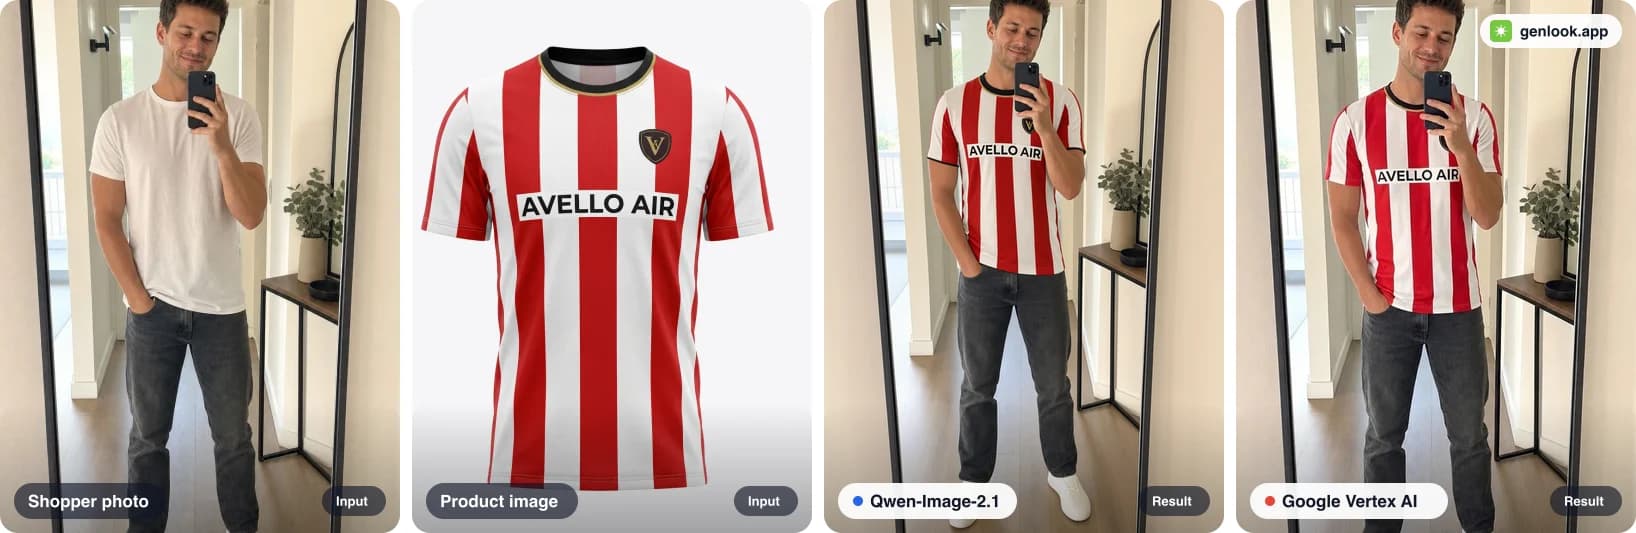
Das Setup: acht Paare aus unseren öffentlichen Try-On-Beispielen, jeweils ein Spiegel-Selfie plus das Produktbild, so wie ein Händler es hochladen würde (als flacher Packshot oder als Foto am Model). Qwen-Image-2.1 lief auf der Comfy Cloud mit 16 Steps. Vertex AI wurde über dessen API angesprochen. Beide liefen durch dieselbe Prompt-Pipeline, ohne LoRA und ohne Post-Processing. Jedes Panel zeigt von links nach rechts: Kundenfoto, Produktbild, Qwen-Image-2.1, Google Vertex AI.
Das Fußballtrikot oben im Beitrag ist der Text-Test. Beide Modelle halten die Wortmarke des Sponsors und das Wappen gut lesbar und an der richtigen Stelle. Keines der Modelle verändert die Hände der Kundin, ihr Smartphone oder den Hintergrund.
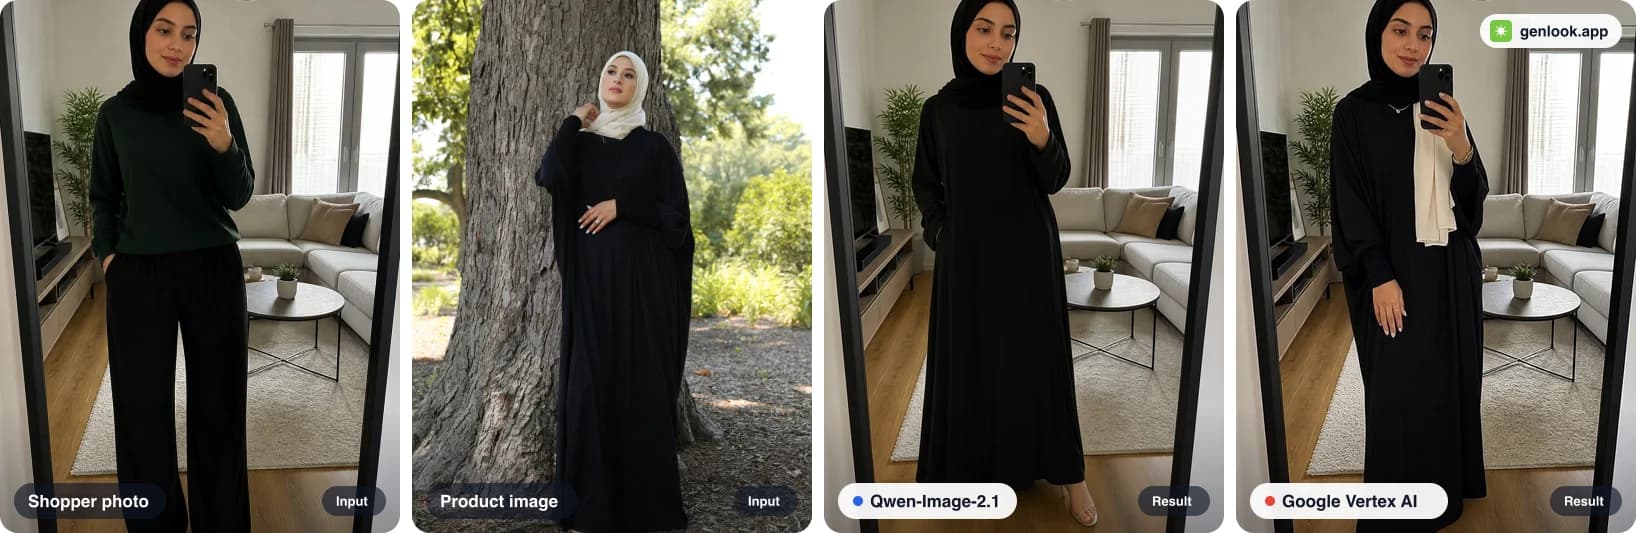
Wo Qwen besser abschneidet. Die Abaya wurde an einem Model fotografiert, das einen cremefarbenen Schal trägt. Vertex hat den Schal zusammen mit dem Kleidungsstück übernommen. Qwen hat nur die Abaya ausgetauscht und sonst nichts.
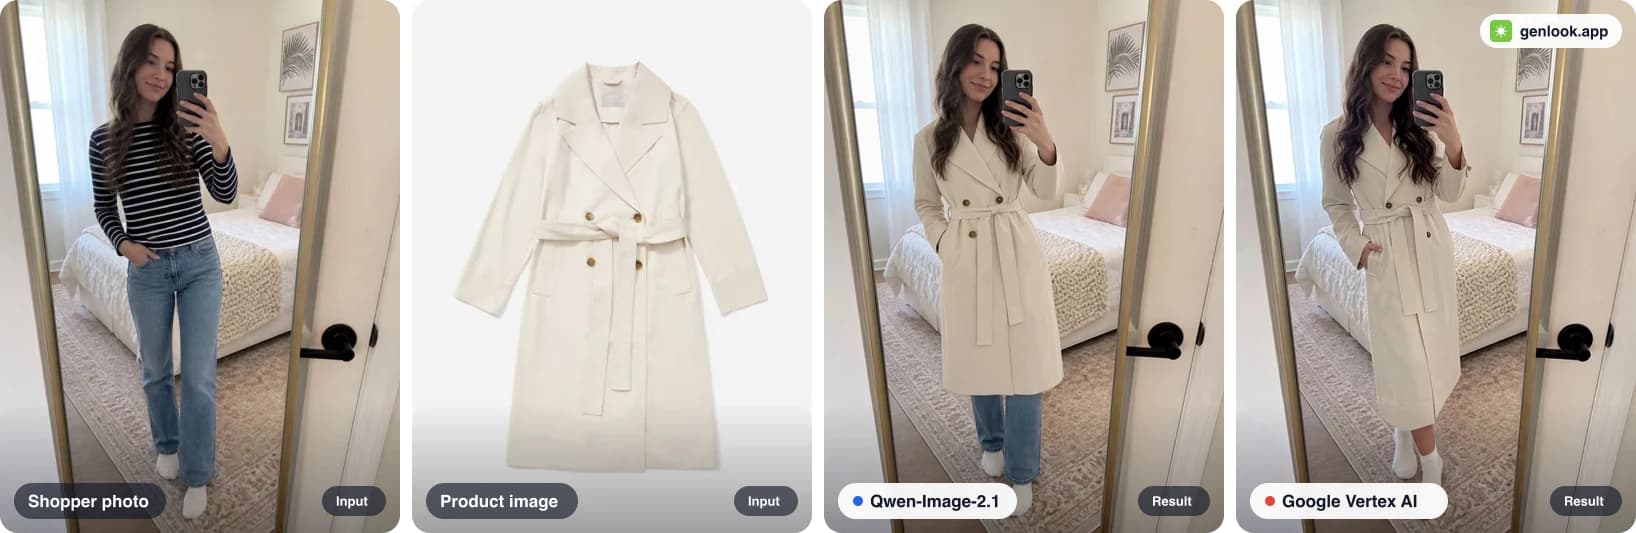
Wo Qwen schwächelt. Der Packshot zeigt den Mantel wadenlang. Vertex behält diese Länge bei, Qwen stoppt am Knie. Gürtel, Verschluss und Revers sind bei beiden Modellen korrekt. Die Saumlänge bei langen Kleidungsstücken war der einzige durchgängige Fehler, der auch bei einem gestuften Maxikleid wieder auftrat.
Die anderen fünf Paare (ein florales Midikleid, ein neonfarbener Hoodie, ein zweiteiliger Sari, ein Maxikleid in Übergröße, ein Brautkleid aus Spitze) waren qualitativ nicht zu unterscheiden. Beide Modelle übernahmen die Bluse und die Borte des Saris, beide trafen die Skalierung des Musters beim Midikleid richtig und keines veränderte ein Gesicht.
Qwen-Image-2.1 vs. Google Vertex AI Try-On
| Qwen-Image-2.1 auf Comfy Cloud | Google Vertex AI Virtual Try-On | |
|---|---|---|
| Erfolgreiche Paare | 8 von 8 | 8 von 8 |
| Median-Zeit pro Anprobe | 9,9 s | 9,3 s |
| Kosten pro Anprobe | ca. 0,005 $ (GPU-Zeit) | 0,06 $ (Listenpreis) |
| Qualität im Direktvergleich | 6 Unentschieden, 1 besser, 1 schlechter | 6 Unentschieden, 1 besser, 1 schlechter |
| Gewichte | offen, Fine-Tuning möglich | geschlossene API |
| Lizenz | nur Forschung, kommerziell nach Absprache | kommerziell |
Die Zeit bei Qwen beinhaltet etwa drei Sekunden Warteschlange in der Comfy Cloud. Die Kosten für Qwen beziehen sich rein auf die GPU-Zeit für das Modell; ein vollständiger Try-On-Request umfasst zusätzlich noch Kleidungsstück-Klassifizierung, Prompt-Erstellung und Qualitätsprüfungen.
Der Haken
Lizenz. Qwen-Image-2.1 wird unter dem Qwen Research License Agreement veröffentlicht, nicht unter Apache 2.0 wie Qwen-Image-Edit-2511. Die Lizenzdatei erlaubt die Nutzung „nur für nicht-kommerzielle Zwecke“, definiert als Forschung oder Evaluierung, und verweist kommerzielle Nutzer darauf, eine Lizenz bei Alibaba zu beantragen. Ein Try-On-Button in einem Onlineshop ist eine kommerzielle Nutzung. Auch für das Self-Hosting ist diese Vereinbarung zwingend.
Die zwei Schwachpunkte. Die Saumlänge bei langen Kleidungsstücken und ausgelassene Sekundärteile bei manchen mehrteiligen Produkten. Beide Fehler sind systematischer Natur – und genau dafür gibt es LoRAs. Bei 7B Parametern lässt sich ein Adapter auf einer einzelnen GPU innerhalb von Stunden trainieren. DiffSynth-Studio auf ModelScope unterstützt das LoRA-Training für 2.1 vom ersten Tag an und ComfyUI lädt Adapter über seine Standard-Nodes. Die Trainingsdaten bestehen aus einem Foto am Model gepaart mit dem passenden Packshot, was bei Modekatalogen in der Regel bereits vorhanden ist. Ein Prompt, der die Kleidungskategorie, den Verschluss und die Länge benennt, behebt die meisten Saumfehler schon von selbst; ein LoRA deckt den Rest ab.
Was das für Genlook bedeutet
Qwen-Image-2.1 ist das erste offene Modell, das bei unseren Beispielen mit einer kommerziellen Try-On-API gleichzieht – und das zu einem Bruchteil der Kosten pro Bild. Wir rüsten die Genlook-Try-On-Pipeline auf, um es dort einzusetzen, wo es seine Stärken ausspielt. Das Ganze läuft on top zur Klassifizierung der Kleidung, dem Prompt-Aufbau und den Qualitätsprüfungen, die jedes Modell bei uns durchläuft, sodass jeder Produkttyp die beste verfügbare Try-On-Qualität erhält. Die beiden oben genannten Schwachpunkte sind die ersten Ziele, die wir mit der Pipeline-Optimierung angehen.
Für Entwickler bietet die Genlook Try-On API einen einzigen Endpunkt für jeden Produkttyp. Ein Credit entspricht einer Anprobe und kostet 0,01 $. Keine Plattformgebühren, keine festen Plätze, kein monatlicher Mindestumsatz, Credits verfallen nicht, und neue Konten starten mit kostenlosen Credits. Der Schnellstart besteht aus vier Aufrufen: Produkt anlegen, Foto hochladen, generieren, Ergebnis abrufen.
Zusammenfassung
- Der Release: ein offenes 7B-Modell, das generiert, mit bis zu 10 Referenzen editiert und Transparenz in einem Checkpoint handhabt. Bestes offenes Modell im hauseigenen Benchmark.
- Beim Try-On: zieht bei 6 von 8 Beispielen Zero-Shot mit Googles Vertex AI Modell gleich. Es ist besser darin, Nicht-Kleidungsstücke in Ruhe zu lassen, schwächelt aber bei der Saumlänge von langen Kleidungsstücken.
- Kosten: etwa 0,005 $ an GPU-Zeit pro Bild gegenüber 0,06 $.
- Der Haken: eine reine Forschungslizenz für Self-Hoster und zwei Schwachstellen, die ein LoRA beheben sollte.
Hol dir einen API-Key unter platform.genlook.app, um die Genlook Try-On API zu nutzen, oder füge Virtual Try-On zu deinem Shop hinzu.
FAQ